面向智能体 skill 的 Copilot AI Credits:为 skill、子智能体与自定义智能体做预算
在 GitHub Copilot AI Credits 下为 SKILL.md 运行、子智能体扇出和自定义智能体定价:测算成本、CLI 的 30 积分下限、预算与 Fusion。
Agent Skills
自 2026 年 6 月 1 日起,GitHub Copilot 中每一次调用模型的交互都以 GitHub AI Credits 计量,一个积分是 0.01 美元。对写 skill 的人来说,这句话改变了工作内容。SKILL.md 不再只是质量问题(“智能体有没有做对”),也成了成本问题(“做对这件事要多少 token,谁来付钱”)。本文写给在 Copilot 上构建和运行 skill、自定义智能体和子智能体工作流的人,梳理计费文档说了什么、哪里没说,以及如何设置预算,避免一个循环悄悄烧掉整月额度。
下面的一切都来自 GitHub 自己的文档、更新日志和 X 上的两条一手帖子。skill 运行的美元和积分数字,是对 GitHub 公布的每 token 价格做的算术,所用的 token 数量是我们虚构并已标明的。我们没有运行过这些工作负载,所以这里没有实测账单、延迟或成功率。凡是文档之间互相矛盾或没有说明的地方,我们都会直说。
skill 作者需要知道的计费事实
Copilot 按模型的标价,把每次交互的 token 成本换算成积分。成本只取决于两件事:运行的是哪个模型,以及消耗了多少 token(全新输入、缓存输入、缓存写入和输出)。套餐价格没有变。Copilot Pro 每月 10 美元,含 1,500 积分;Pro+ 每月 39 美元,含 7,000 积分;Max 每月 100 美元,含 20,000 积分。Business 与 Enterprise 的每个席位分别包含 1,900 和 3,900 积分,在整个组织内共享。包含的积分在每月 1 日 UTC 00:00:00 重置,不结转。
代码补全和下一处编辑建议不消耗积分。Chat、CLI、云端智能体、Spaces、Spark、代码审查和第三方编码智能体则会消耗积分。在我们读到的内容里,skill 并不是拥有独立计量的单独产品。skill 是 Copilot 在相关时加载的一个指令文件夹,所以它的成本体现在运行它的那个界面里:编辑器中的智能体模式、Copilot CLI、Copilot 应用、云端智能体或代码审查。文档说,智能体 skill 适用于以上所有这些。
这个工作模型有一个实际推论。skill 引发的 token 来自三个地方:Copilot 从 skill 文件夹加载的指令、智能体在遵循指令时读取的文件和工具输出,以及它写回的输出。把指令加载进上下文是我们根据 token 计费方式做的推断,因为文档描述了加载,却没有逐项列出。请把它当作可以测试的成本,而不是可以查到的数字。
哪些界面运行 skill,以及各自能控制什么
下表综合了计费文档、skill 文档和 CLI 文档。“支持 skill”来自智能体 skill 概览。控制手段一栏只列出文档为该界面描述过的控制。
| 界面 | 是否按积分计费 | 是否支持 skill | 文档记载的支出控制 |
|---|---|---|---|
| VS Code 与 JetBrains 中的智能体模式 | 是 | 是 | 模型选择、账单设置中的预算 |
| Copilot CLI | 是 | 是 | 会话上限(公开预览)、模型选择、预算 |
| Copilot 应用 | 是 | 是 | 模型选择、Fusion 强度、预算 |
| Copilot 云端智能体 | 是,依据计费页面 | 是 | 预算、模型选择;未记载每会话上限 |
| Copilot 代码审查 | 是,外加 Actions 分钟 | 是 | 审查强度级别、预算 |
有两行值得再看一眼。云端智能体自己的介绍页仍然说它使用 GitHub Actions 分钟和 Copilot premium request,而个人用户计费页面把它列在 AI 积分功能之中。这可能是两种计量同时运行,也可能是一个页面落后于另一个。我们无法从页面上判断,所以不给出云端智能体每次会话的价格,并建议在安排任何无人值守任务之前,先从用量页面读出最初几次运行的数据。
另一行是代码审查。每次审查要计两次费:token 按 AI 积分计,智能体基础设施则按常规每分钟费率消耗 GitHub Actions 分钟。因为模型是自动选择且不公开的,GitHub 按强度级别公布每次审查的估算积分成本。
| 审查强度级别 | 每次审查的典型范围 | 大致平均值 |
|---|---|---|
| Lite | $0.05 至 $1 | $0.25(25 积分) |
| Balanced | $0.25 至 $5 | $1.50(150 积分) |
| Max | $1.50 至 $25 | $10(1,000 积分) |
GitHub 把这些标为估算值,不含 Actions 分钟,并且会随拉取请求大小和仓库自定义指令而上升。积分一栏是我们按每积分 0.01 美元换算的。如果你添加了一个审查 skill 或很长的仓库指令文件,估算值会上升,而不是下降。
上线前先给 skill 运行定价
各模型价格来自 GitHub 的模型与定价页面,按每百万 token 标价。乘以 100 就得到积分。下面是跨越整个价格范围的四个模型的默认档价格。
| 模型 | 输入 | 缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
| Claude Haiku 5.5(上下文最高 100K) | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-6.1 Terra(上下文最高 272K) | $1.00 | $0.05 | $1.25 | $5.00 |
| Claude Sonnet 5.5 | $2.00 | $0.10 | $2.50 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $5.00 | $20.00 |
有几个模型在超过某个上下文阈值后切换到更高的价格,GPT-6 和 GPT-6.1 系列是 272K 输入 token,Claude Haiku 5.5 是 100K。一个把大型文件树塞进单次调用的 skill 可能越过这条线,所以下面 Haiku 的数字假设每次调用都低于 100K。
我们给三种 skill 形态定了价。token 数量是我们挑选的看起来合理的假设值,单位是百万 token,不是测量值。
| 形态 | 全新输入 | 缓存输入读取 | 缓存写入 | 输出 |
|---|---|---|---|---|
| A. 一个 skill、一个智能体(一次聚焦的审查或文档更新) | 0.06 | 0.20 | 0.02 | 0.008 |
| B. 同一个 skill 加三个子智能体,每个有自己的上下文 | 0.36 | 1.10 | 0.11 | 0.038 |
| C. 在一次会话中运行的长 skill 链(计划、编辑、测试、修复) | 0.40 | 2.00 | 0.20 | 0.05 |
形态 B 是主智能体的形态 A,再加上三个子智能体,每个使用 0.10 全新输入、0.30 缓存读取、0.03 缓存写入和 0.01 输出。合计正好是 B 行。
| 形态 | Haiku 5.5 | GPT-6.1 Terra | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|---|
| A. 一个 skill、一个智能体 | 1.45 积分 | 13.5 积分 | 27 积分 | 54 积分 |
| B. skill 加三个子智能体 | 7.98 积分 | 74.25 积分 | 148.5 积分 | 297 积分 |
| C. 长 skill 链 | 11 积分 | 100 积分 | 200 积分 | 400 积分 |
形态 A 在 Sonnet 5.5 上的那一行展示了计算方法。0.06 百万全新输入按 2.00 美元是 0.12 美元。0.20 百万缓存输入按 0.10 美元是 0.02 美元。0.02 百万缓存写入按 2.50 美元是 0.05 美元。0.008 百万输出按 10.00 美元是 0.08 美元。合计 0.27 美元,即 27 积分。
有三点很突出。模型选择起决定作用:同一次运行在 Opus 5.5 上是 54 积分,在 GPT-6.1 Terra 上是 13.5 积分,相差四倍。扇出不是免费的:给主智能体加上三个子智能体,使 Sonnet 5.5 上的 27 积分变成 148.5 积分,约为 5.5 倍,原因是隔离的上下文窗口,因为每个子智能体都要重新读取自己需要的内容,而不是共享父智能体的缓存。缓存条款也很关键:在 Sonnet 5.5 的形态 C 中,200 万缓存 token 只花 0.20 美元,同样的 token 若按全新输入计费则要 4.00 美元。
一份额度能跑多少次
把套餐的积分除以每次运行的积分,得到一个量级参考。它忽略了你当月在 Copilot 里做的其他一切,包括聊天,所以请把它当作额度所能支撑次数的上限。
| Sonnet 5.5 上的形态 | 每次运行的积分 | Pro(1,500)可运行次数 | Pro+(7,000)可运行次数 | Max(20,000)可运行次数 |
|---|---|---|---|---|
| A. 一个 skill、一个智能体 | 27 | 55.6 | 259.3 | 740.7 |
| B. skill 加三个子智能体 | 148.5 | 10.1 | 47.1 | 134.7 |
| C. 长 skill 链 | 200 | 7.5 | 35 | 100 |
一个团队每天运行某个审查 skill 20 次,按 22 个工作日算,每月是 440 次。按 Sonnet 5.5 上的形态 A,这是 11,880 积分。这比 Pro+ 包含的还多,约占 Max 的 59%,而此时还没有人打开过聊天。在 GPT-6.1 Terra 上,同样的 440 次运行花 5,940 积分。这些是在我们假设的画像上得到的算术结果,目的是展示哪个杠杆能改变数字。换模型能让它减半。减少每次运行的 token 会按比例改变它。换套餐只改变预付的额度有多少。
如果你的 skill 运行在由组织拥有的仓库里,包含的积分是共享的。一百个 Copilot Business 席位构成 190,000 积分的共享池,重度 skill 用户与所有人从同一个池子里扣。用户级预算的存在就是为了防止某一个人把它耗光。下面会详细说明。
skill 运行时的 Fusion 与 Auto
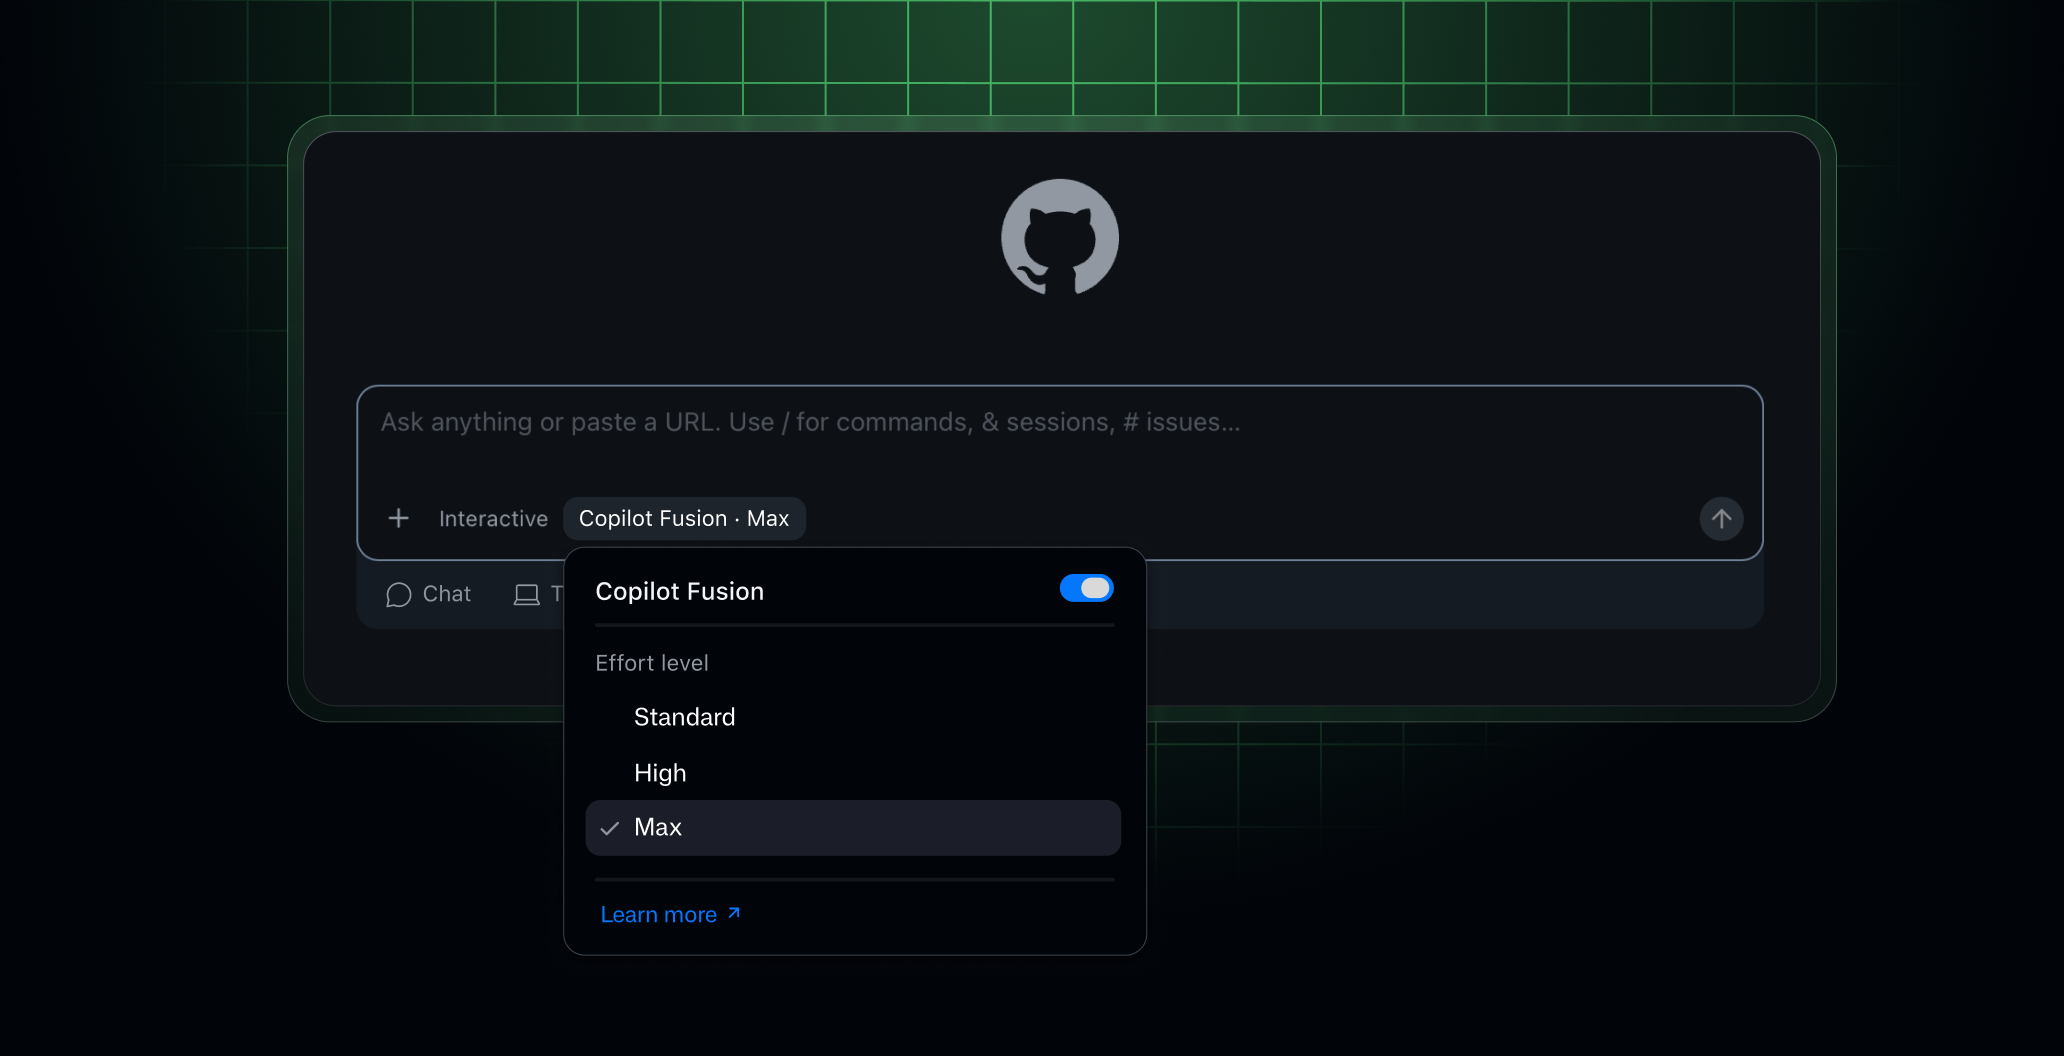
Copilot Fusion 于 2026 年 10 月 28 日正式发布。它是路由器和编排器,不是模型。它用到的每个模型都按该模型的标准价格计费,没有单独的 Fusion 费用,付费套餐在 2026 年 11 月 30 日之前享受模型成本 30% 的折扣。Fusion 对每个提示词在三种执行模式中选择:single(单一)、cascade(级联:高效模型起草,评判者接受或升级)和 critique(批评:一个模型起草,多个模型并行批评)。Fusion High 和 Max 在一个任务里可能用到多个模型,所以一个任务可能比 Standard 消耗更多积分。
对 skill 作者而言,交互细节比标题更重要。
- 文档列出的 Fusion 支持范围是 VS Code、Copilot 应用、Copilot CLI 和 JetBrains IDE。GitHub.com 上的云端智能体不在这份清单里。如果你打算在云端智能体任务上运行 Fusion,请先查看最新文档。
- Fusion 与子智能体各自独立工作,不会启动子智能体。一个扇出到子智能体的 skill 仍要为子智能体付费,而 Fusion 的内部路由是叠加在主会话所做之事上的第二层。
- Fusion 没有自己的上下文窗口,显示的是依据所用模型中最小上限得出的保守数值。
- 如果 Fusion 丢弃了某份草稿,该草稿已经做出的文件编辑不会自动撤销。会写文件的 skill 之后应当跟一个提交前的审查步骤。
- Fusion 会尽量让主对话保持在同一个模型上,使缓存 token 持续发挥作用。任何在会话中途切换模型的做法,都可能把廉价的缓存读取变成全新输入。
Auto 模型选择是另一个路由器。它有 Efficiency、Balance 和 Intelligence 三个档位,按它选中的模型计费,并给付费套餐在 Copilot Chat 和云端智能体中的模型成本打 9 折。我们保存的两个版本的文档,在这 10% 是否也覆盖 CLI 和 Copilot 应用上不一致。文档没有说明这 10% 与 Fusion 的 30% 能否叠加,所以做预算时请按不能叠加来算。
Artificial Analysis 在其 Coding Agent Index 上,用 Copilot CLI 对 Fusion 的 max 强度做了基准测试,报告每个任务 5.59 美元,而使用 Opus 5.5 max 的 Claude Code 为 11.42 美元,Fusion 得 60 分,对方 62 分。GitHub 的更新日志另外提到每个任务耗时约少 40%,这个数字只出现在 GitHub 自己的文字里。按每积分 0.01 美元,5.59 美元是 559 积分,加上 30% 折扣后约为 391 积分。这是一项基准针对编码任务的 API 成本,由第三方运行,对你的 skill 并不能说明什么确定的事,所以我们只把它当作量级参考。
skill、自定义智能体及其存放位置
skill 文档说,Copilot 支持项目 skill(位于 .github/skills、.claude/skills 或 .agents/skills),以及个人 skill(位于 ~/.copilot/skills 或 ~/.agents/skills)。每个 skill 放在自己的小写、连字符命名的目录里,文件名为 SKILL.md。frontmatter 需要 name 和 description,license 可选。description 告诉 Copilot 何时使用这个 skill,所以它同时也决定了 skill 何时被加载,这既是路由决策,也是成本决策。一个匹配太多提示词的 description,会把 skill 加载进并不需要它的会话里。
自定义智能体是带 YAML frontmatter 的 Markdown 智能体配置文件。它们可以放在用户级($HOME/.copilot/agents)、仓库级(.github/agents)、组织级和企业级。默认情况下,智能体可以使用所有可用工具,包括 MCP 服务器工具,除非你限制 tools 列表。这类配置文件可用于云端智能体、IDE 中的云端智能体、Copilot 应用和 Copilot CLI。
tools 列表是你自己手里最便宜的控制手段。无法调用大型搜索工具的智能体,就无法用搜索结果填满自己的上下文。一份只列出三个工具的配置,从构造上就让工具输出保持很小。文档把 tools 属性描述为可选、默认为全部,这意味着没写它的配置承载着最大的接触面。
skill 文档还描述了 skill frontmatter 中的 allowed-tools。它列出 Copilot 无需每次询问就可使用的工具。这是权限功能,不是成本功能,而且文档带有一条警告:不要为没有审查过的 skill 预先批准 shell 或 bash。我们在此重复这一点,因为预先批准了 shell 的无人值守 skill,同时也是一个可能陷入循环的无人值守 skill。
如果你编写的 skill 要给别人安装,注册表页面是个有用的起点。agent-skill-creator 讲的是把重复的工作流写成 skill,agents-md-generator 生成会成为每个会话上下文一部分的 AGENTS.md 指令文件,context-optimization 讲的是让上下文保持有针对性,这正是你的积分余额在意的同一个杠杆。GitHub 文档自己的示例 skill 是 github-actions-failure-debugging,它是一堂很好的成本课:它的指令让智能体调用一个返回失败任务日志 AI 摘要的工具,而不是把成千上万行原始日志拉进上下文,只有摘要不够时才获取完整日志。
Copilot CLI 中的子智能体:隔离是要花 token 的
Copilot CLI 包含一些内置智能体,主智能体可以把它们作为子智能体运行:explore、task、general-purpose、code-review、research、rubber-duck 和 security-review。子智能体拥有独立的上下文窗口,所以它们能处理子任务而不会弄乱主智能体的上下文,其中一些可以并行运行。文档把 /fleet 描述为一种加快大型任务的方式,即把任务拆成由子智能体运行的并行子任务。
速度与成本在这里朝不同方向用力。并行子智能体完成得更快,而我们的形态 B 显示了它们的代价:在同一模型上是形态 A 的 5.5 倍。隔离是好处,因为主上下文保持较小,但每个子智能体都要付费重建自己需要的上下文。对 skill 而言,正确的问题不是“这里该不该用子智能体”,而是“每个子智能体读的内容,是否比父智能体做同样的工作所需读的更少”。
有些内置智能体在设计上就比较便宜。explore 智能体被描述为快速、轻量、只读,并可与其他智能体并行运行。task 智能体成功时返回简短摘要,失败时返回完整输出,这样测试和构建的噪声就不会进入父智能体的上下文。rubber-duck 智能体运行在与驱动你会话不同的模型上,也就是说,第二意见同时意味着在主模型之外再加第二个模型的费率。文档没有给出这些智能体的积分价格,所以请自己测量。
要构建编排子智能体的 skill,subagent-driven-development 讲的是通过相互独立的任务执行实施计划,agent-context-isolation 是注册表中最接近上述上下文隔离权衡的页面。这两个都不是专门针对 Copilot 的 skill,它们只是注册表链接,并不表示它们在 Copilot 的计费下表现相同。
还有两个 CLI 行为会影响成本。Copilot CLI 有无限会话,会自动压缩并总结对话历史,另有一个很少需要用到的手动 /compact 命令。最佳实践页面还建议在不相关的任务之间使用 /clear 或 /new。这两条既是预算建议,也是整洁习惯:每一轮都会重新发送上下文,所以带着昨天无关工作的会话,要为携带它们付费。
会话上限:唯一的单次运行封顶及其下限
Copilot CLI 有 AI 积分会话上限,目前处于公开预览。在交互式会话中,/limits set max-ai-credits NUMBER 为会话设上限,/limits unset 取消上限。在非交互式运行中,传入 --max-ai-credits NUMBER。最小值是 30 积分。达到上限时智能体会干净地停下,在交互模式下会提示你重置上限并继续。这是软上限:正在进行的响应会先完成,所以实际用量可能略高于你设定的数字。它也不是月度上限。
对照我们的测算表来看,30 积分的下限值得细读。在 Sonnet 5.5 上,30 积分是 0.30 美元,按标价可买 150,000 个全新输入 token 或 30,000 个输出 token。我们的形态 A 运行在 Sonnet 5.5 上花 27 积分,所以一次聚焦的 skill 运行几乎占满你能设定的最小上限。在 Opus 5.5 上,同样的 0.30 美元只能买 75,000 个全新输入 token 或 15,000 个输出 token,形态 A(54 积分)根本放不进最小上限。在 Haiku 5.5 上,下限 0.30 美元可买 300 万个全新输入 token 或 60 万个输出 token,非常宽裕。
| 模型 | 30 积分($0.30)能买到:全新输入 | 30 积分能买到:输出 |
|---|---|---|
| Claude Haiku 5.5 | 3,000,000 token | 600,000 token |
| GPT-6.1 Terra | 300,000 token | 60,000 token |
| Claude Sonnet 5.5 | 150,000 token | 30,000 token |
| Claude Opus 5.5 | 75,000 token | 15,000 token |
这些是按标价的换算,不是带缓存读取的混合会话实际会消耗的量。它们确实说明了,为什么对 Haiku 的短任务有效的上限,在 Opus 任务上几乎起不到保护作用,也说明了为什么针对探索性会话调好的上限应当按任务类型分别设置。对定时或脚本化运行,请显式设置 --max-ai-credits,并按你实测的单次运行成本的若干倍来定,而不是随手取一个整数。
给向团队发布 skill 的人的预算
个人用户在账单设置里有一个针对额外用量的美元预算,可选的提醒在 75%、90% 和 100%,还有一个在达到预算时停止使用的选项。Bundled AI credits 预算类型为所有使用积分的功能设置统一上限。因为 1 积分是 0.01 美元,10 美元的预算就是 1,000 积分。
组织有更多层级。用户级预算限制一个人从共享池和付费用量中合计能消耗多少,并且始终硬性停止。成本中心、组织和企业预算只限制共享池耗尽之后才开始产生的计量费用,只有启用了 Stop usage when budget limit is reached 才会停止使用,而该选项默认关闭。请求按顺序检查:先用户级预算,再共享池,最后是计量预算。计量阶段还要求 AI 积分付费用量策略处于启用状态,而对组织来说它默认是启用的。
如果你向团队发布一个 skill,随之而来有三个团队层面的决定。
- 在这个 skill 变得流行之前,先设好通用的用户级预算。一位热情的用户整天运行形态 B,就可能耗尽为许多人准备的共享池。
- 为冲刺或事故处理使用带到期日的单个用户覆盖,而不是调高通用数字。
- 决定是否允许 Fusion,以及它可以使用哪些模型。企业管理员可以只对 Fusion 禁用特定模型,而不必对所有人禁用。
关于监控,用量页面按模型拆分积分,文档称你通常无法把积分追溯到具体的提示词、会话或精确的功能。对 skill 作者而言,这意味着你无法从仪表盘的某一行读出一个 skill 的成本。你可以框定它的范围。在一个安静的账户上单独运行这个 skill,记下按模型的变化,再换第二个模型重复一次。最低客户端版本对准确的计价和提醒也很重要,例如 VS Code 1.120 和 Copilot CLI 1.0.48。
写出更省钱的 skill
上面的一切可以归结为 skill 本身的设计规则。这些规则源自 token 计费的工作方式,没有一条来自 GitHub 的基准测试。
- 让 description 保持收窄。它决定 skill 何时加载,所以含糊的 description 会把 skill 加载进从未需要它的会话。
- 把较长的参考资料放进 skill 文件夹里的单独文件,并告诉智能体何时读取哪一个。文档说,Copilot 会发现 skill 目录里的所有文件,并和指令一起提供给智能体,这使得保持
SKILL.md简短变得可行。 - 返回摘要,而不是原始输出。GitHub 的示例 skill 就是用它的任务日志摘要工具这样做的。一个返回 40 行而不是 4,000 行的工具,会在之后每一轮都节省输入 token,因为输出会一直留在上下文里。
- 把自定义智能体配置中的
tools列表限制在这项工作所需的范围内。 - 除非节省明显,不要让 skill 在会话中途切换模型,因为切换可能破坏缓存。
- 对于扇出,要数一数每个子智能体必须读多少。如果答案是“父智能体读过的大部分”,那么扇出买的是速度,而不是节省。
- 让无人值守的 skill 以停止条件和会话上限收尾,上限按实测单次运行成本的若干倍来定。
- 在任何写草稿的流程之后加一个审查步骤,因为被丢弃的 Fusion 草稿可能留下编辑。
针对具体工作选择哪条路线,是模型加界面的决策。下面的决策表汇总了文档所支持的内容,并带有上文的算术说明。
| 如果你的 skill 是…… | 优先选择 | 依据(来自文档与我们的算术) | 注意 |
|---|---|---|---|
| 每天运行很多次的简短聚焦任务 | 轻量或中档模型,或 Fusion Standard | 每次运行的积分随模型价格变化,形态 A 中 Terra 为 13.5,Opus 为 54 | Haiku 的 100K 上下文档位 |
| 长的计划、编辑、测试链 | 中档模型,会话上限设为实测成本的若干倍 | 形态 C 在 Sonnet 5.5 上达到 200 积分 | 切换模型造成的缓存损失 |
| 跨相互独立文件的扇出 | 仅当每个子智能体读的远少于父智能体时才用子智能体 | 形态 B 约为形态 A 的 5.5 倍 | 每个子智能体重建上下文 |
| 定时的无人值守 CLI 任务 | --max-ai-credits 加开启 Stop usage 的 Bundled AI credits 预算 | 会话上限是软的,预算是后盾 | 30 积分的最小值 |
| 拉取请求审查 skill | 默认 Lite,有选择地用 Balanced | 每次审查平均 25 与 150 积分,未计 Actions 分钟 | PR 大小和自定义指令会抬高成本 |
| GitHub.com 上的云端智能体任务 | 在安排之前,先从用量页面读出最初几次运行 | 计费被列为积分,介绍页仍提到 premium request | 没有记载每会话数字 |
本站的其他智能体 skill 指南从模型一侧讨论了同样的预算问题。参见 GPT-6 上智能体 skill 的模型路由、Opus 5.5 与 Sonnet 5.5 对比(面向智能体 skill)、ultrafast 与 pro 档位的成本规划 和 Codex Security 的云端智能体工作流。要在不依赖 Copilot 的情况下统计 token 并在模型之间路由,ai-cost-optimizer 是一个面向多模型路由的注册表 skill。
我们无法确认的内容
- Copilot Free 和 Student 积分额度的大小。我们读到的文档说它们有额度,但没有给出数字。
- 云端智能体每次会话的任何固定积分价格,以及它介绍页提到的 Actions 分钟和 premium request 是否与积分并行适用。
- 任何针对每个 skill 或每个自定义智能体的收费。我们没找到,也无法证明不存在。
- 内置子智能体以及 Fusion 内部各步骤的积分价格。文档说你可以把鼠标悬停在回答下方的强度级别上,查看用了哪些模型。它们没有列出每一步的积分。
- Fusion 的 30% 与 auto 的 10% 折扣是否能叠加,以及这 10% 是否覆盖 CLI 和 Copilot 应用。我们保存的两个版本的文档不一致。
- skill 指令所占的上下文,是否像其他输入一样计费。我们是根据 token 计费推断的,文档没有逐项列出。
- 各模型价格会变化。Gemini 4 Argon 的价格是促销价,截至 2026 年 12 月 1 日;每个套餐的弹性额度被描述为可变。
结论
在积分计费之下,skill 的成本就是它让智能体使用的 token 的成本,按运行它的模型定价。这使得三个杠杆值得掌握:模型、skill 增加或避免的上下文,以及扇出。在中档模型上运行的简短 skill 便宜到套餐额度几乎无关紧要。在前沿模型上做扇出的 skill 则不然,而且在积分之下,余额用完时不会静默回退到更便宜的模型,结果是停止或产生账单。
实际的流程很简短。用你自己的 token 数量和上面的公式,给一次运行定价。在 skill 传播开之前,设好带硬性停止的用户级预算或 Bundled AI credits 预算。对无人值守的运行在 CLI 里设置会话上限,大小高于你实测的成本,并且要清楚 30 积分的下限。在 2026 年 11 月 30 日之前,趁 30% 折扣还在,试一试 Fusion,然后按标价再算一遍,因为 12 月看起来就是不打折的那个数字。
来源
- GitHub Docs, Usage-based billing for individuals: https://docs.github.com/en/copilot/concepts/billing/usage-based-billing-for-individuals
- GitHub Docs, Usage-based billing for organizations and enterprises: https://docs.github.com/en/copilot/concepts/billing/usage-based-billing-for-organizations-and-enterprises
- GitHub Docs, Models and pricing for GitHub Copilot: https://docs.github.com/en/copilot/reference/copilot-billing/models-and-pricing
- GitHub Docs, Budgets for usage-based billing: https://docs.github.com/en/copilot/concepts/billing/budgets-for-usage-based-billing
- GitHub Docs, Setting up budgets to control spending on metered products: https://docs.github.com/en/billing/how-tos/set-up-budgets
- GitHub Docs, Setting an AI credit session limit in GitHub Copilot CLI: https://docs.github.com/en/copilot/how-tos/copilot-cli/set-ai-credit-session-limit
- GitHub Docs, Monitoring your GitHub AI Credits usage: https://docs.github.com/en/copilot/how-tos/manage-and-track-spending/monitor-ai-credit-usage
- GitHub Docs, About GitHub Copilot Fusion: https://docs.github.com/en/copilot/concepts/models/copilot-fusion
- GitHub Docs, About GitHub Copilot auto model selection: https://docs.github.com/en/copilot/concepts/auto-model-selection
- GitHub Docs, About GitHub Copilot cloud agent: https://docs.github.com/en/copilot/concepts/agents/cloud-agent/about-cloud-agent
- GitHub Changelog, Route and orchestrate models with GitHub Copilot Fusion, 2026 年 10 月 28 日: https://github.blog/changelog/2026-10-28-route-and-orchestrate-models-with-github-copilot-fusion/
- GitHub Blog, GitHub Copilot is moving to usage-based billing, 2026 年 4 月 27 日: https://github.blog/news-insights/company-news/github-copilot-is-moving-to-usage-based-billing/
- @github on X, 2026 年 10 月 28 日: https://x.com/github/status/2115480207469560109
- @ArtificialAnlys on X, 2026 年 10 月 28 日: https://x.com/ArtificialAnlys/status/2115477376981508419


