Opus 5.5 与 Sonnet 5.5 用于智能体 skill:每个 skill 该选哪个模型和 effort
在 Claude Code 里,skill 和子智能体该跑在哪个 Claude 模型、哪一档 effort 上:Opus 5.5 与 Sonnet 5.5 的路由、SKILL.md 的 token 成本和扇出算术。
Agent Skills
Skill 本质上是一段在别人上下文窗口里运行的提示词,读它的模型决定了这份指令在真实仓库里能保留多少。Anthropic 的 Claude 5.5 双模型给了你两个差别很大的运行位置:Opus 5.5,每百万输入 token 4 美元、每百万输出 token 20 美元;Sonnet 5.5,两项价格都正好是它的一半。本文不是泛泛的“哪个模型更聪明”对比,而是只问一个构建智能体的人在 Claude Code 里天天会遇到的问题:当一个 SKILL.md 或子智能体定义被触发时,该由哪个模型、哪一档 effort 来干活,这个选择又要花多少钱?
简短版本:规划和最终裁决放给 Opus 5.5,执行和扇出放给 Sonnet 5.5;effort 保持在 medium,直到你自己的数据说明该改;优化时间先花在 effort 和子智能体数量上,再去考虑从 skill 文件里省 token。除非标明来自 Artificial Analysis(本文唯一的独立来源),否则下面每个基准数字都是 Anthropic 的厂商自报。每个美元数字都是对公开价目表做的算术,不是对任何代码库的实测。
简短回答
对大多数由 skill 驱动的 Claude Code 工作,分工很简单:会话跑在 medium effort 的 Sonnet 5.5 上;当某个 skill 要做一个出错代价很高的判断时,再用 Opus 5.5,比如写计划、判断一个改动是否可以合并,或是理清两次 Sonnet 尝试都没解决的故障。Claude Code 已经自带这样的模式。模型配置文档把 opusplan 描述为一种特殊模式:规划模式下使用 opus,随后切换到 sonnet 执行;在 Anthropic API 上,这两个别名分别解析为 Opus 5.5 和 Sonnet 5.5。
Anthropic 自己的材料为这种分工提供了三条依据,每一条都有前提。第一,Anthropic 的 Sonnet 5.5 页面说,Opus 5.5“在需要持续判断的复杂开放式工作上仍然明显更强”,这正是 skill 工作流中规划和审查的那一端。第二,在 FrontierCode 基准上,Anthropic 报告 Opus 5.5 为 54.4%,Sonnet 5.5 在 xhigh 为 52.1%、在 max 为 46.2%,所以差距是真实的,但在 Sonnet 最擅长的设置下很小。第三,同一行的脚注说,Sonnet 5.5 在 max 的得分低于 xhigh,部分原因是它更频繁地运行 Claude Code 的代码审查 skill,而这个 skill 会把一次审查拆给许多子智能体;在 Cognition 检查的两个案例中,这导致了超时或任务之外的额外改动。对于“effort 和子智能体扇出是成本与质量的调节旋钮,而不是免费升级”这个观点,这条脚注是两篇发布文章里最有力的一条论据。
如果读完只改一件事,那就是刻意地设置 effort。在 API 上,Opus 5.5 默认 medium,Sonnet 5.5 默认 high,所以更便宜的那个模型默认反而想得更多。一个从不提 effort 的 skill,实际上悄悄选了每个模型曲线上不同的点。
模型运行 Skill 时有什么不同
聊天提示词只读一次,而 skill 在三个方面不同,这些差别会影响模型选择。
第一,skill 是一直留在对话里的常驻指令。Claude Code 的 skills 文档说,被调用时,渲染后的 SKILL.md 内容会作为单条消息进入对话,之后的轮次不会再次读取。这意味着它的 token 会在会话剩余部分一直留在上下文里,此后每一轮都要为它们支付缓存读取费用。每轮的成本很小,但每轮都要付,长会话里一个冗长的 skill 会累积起来。具体算术见后文。
第二,skill 是模型需要在许多次工具调用中持续遵守的指令,而不是一次性回答。一个模型如果只遵循五步 skill 的前两步,后三步就跑偏,结果会不如一个能遵循全部五步的较弱模型。文档对压缩(compaction)也有类似的说明:对话被压缩之后,Claude Code 可能只保留被调用 skill 的开头部分,所以最重要的指令应放在文件靠前的位置。这条建议与模型无关,但与模型选择有交互:越能在多次工具调用中把一条长指令放在视野里的模型,越能容忍更长的 skill。Anthropic 的两个页面都没有为任一模型发布 skill 遵循度的基准,所以任何“某个模型更会遵循 skill”的说法,都应当当作可以测试的悬而未决的问题,而不是已有文档的事实。
第三,skill 经常会做委派。审查 skill、调研 skill 或实施计划的执行器,通常会启动子智能体,而每个子智能体都是一个独立的上下文,有自己的模型和 effort。最大的成本乘数就在这里,这也是本文要用完整一节来讲扇出的原因。
Claude Code 给你的控制项
Claude Code 在多个层级暴露了模型和 effort,优先级顺序在文档里有明确记载。了解它能避免最常见的路由 bug:以为子智能体跑在 Sonnet 上,其实上游有东西把它固定到了 Opus。
对子智能体来说,model frontmatter 字段接受别名(sonnet、opus、haiku 或 fable)、完整模型 ID(如 claude-opus-5-5),或 inherit(沿用主对话的模型)。文档直接给出了解析顺序:先是 Claude 在 Agent 工具调用中可以传入的单次调用 model 参数,然后是子智能体定义里的 model frontmatter,再是 CLAUDE_CODE_SUBAGENT_MODEL 环境变量,最后是主对话的模型。在这种单次调用中,Claude 只能传别名,不能传完整 ID 或 inherit。同一份文档还为子智能体列出了 effort 字段,可选 low、medium、high、xhigh 和 max,并注明可用档位取决于模型,且该字段会覆盖会话的 effort 级别,但不会覆盖环境变量 CLAUDE_CODE_EFFORT_LEVEL。
由此得出两个结论。如果你在 shell 配置里导出 CLAUDE_CODE_EFFORT_LEVEL,好让交互式会话更仔细,那也等于让每个子智能体的 effort 字段失效,因为环境变量优先。另外,如果你在会话中途用 /model 切换模型,这个切换会波及继承主对话模型的子智能体,因为 Claude Code 在启动它们时,是从会话当前的模型来解析的。文档给出的实用说法是:在 Claude 委派调研或测试运行之前先切到 Opus,那么这些委派出去的工作也会跑在 Opus 上。
内置的辅助子智能体在加载内容上也有区别。文档说,Explore 和 Plan 启动时不带你的 CLAUDE.md 文件和 git 状态快照,目的是让调研又快又省,而其他内置和自定义子智能体则两者都加载,除非你在自定义定义里设置 omitClaudeMd。Plan 继承主对话的模型,Explore 通常也使用主对话的模型。所以,“便宜的调研子智能体”只有在你给了它更便宜的模型或更低的 effort 时才算便宜;否则它每个 token 的价格,和派生它的那个会话一样贵。
Skills 现在也记录了同样的两个字段。Claude Code 的 skills 文档把 model 和 effort 列为 SKILL.md 的可选 frontmatter。model 接受与 /model 相同的取值,或 inherit,并在当前轮次剩余部分生效,不会保存到设置里,所以下一次提示时会话模型恢复。effort 接受 low、medium、high、xhigh 或 max,覆盖会话级别,省略时回退到通常的 effort 解析顺序。配合 context: fork 时,model 的值转而设置被派生子智能体的模型。可用的 effort 档位取决于模型,组织的 availableModels 白名单也可以否决某个模型。对于既要廉价执行、又要昂贵判断的 skill,把任务委派给在定义里设置了 model 和 effort 的子智能体,仍是更干净的拆分方式,因为 skill 自己的 frontmatter 作用于整个轮次。
最低版本也要留意。Anthropic 的模型页面写明,Sonnet 5.5 需要 Claude Code 2.1.284 或更高版本,Opus 5.5 需要 2.1.280 或更高版本。版本过旧的安装会让请求失败而不是回退,在日志里看起来就像路由 bug。
本文依赖的数字
所有价格来自 Anthropic 的定价页和产品页,单位为每百万 token。
| Opus 5.5 | Sonnet 5.5 | |
|---|---|---|
| 输入 | $4 | $2 |
| 输出 | $20 | $10 |
| 缓存读取 | $0.20 | $0.10 |
| 缓存写入 | $5 | $2.50 |
| 上下文窗口 | 1M token | 1M token |
| 最大输出 | 128K | 128K |
| 默认 effort(API) | medium | high |
| Effort 档位 | low、medium、high、xhigh、max | low、medium、high、xhigh、max |
| 发布 | 2026 年 9 月 22 日 | 2026 年 9 月 28 日 |
有两个细节能省钱。Sonnet 5.5 的缓存读取价格是 0.10 美元,因为 Anthropic 在 10 月 7 日把它减半,并称这让 Sonnet 5.5 在大多数长时间运行的工作上便宜约 20%。如果你读的是发布周的成本表,它可能还带着旧价格。另外,Sonnet 一列的每个价格都正好是 Opus 一列的一半,所以在 token 数相同的情况下,两个模型的成本比恒为 2,与负载形态无关。唯一的变量是每个模型花多少 token。如果 Sonnet 5.5 在同一个任务上花了两倍的 token,账单就一样。

重度使用 Skill 的会话里,token 花在哪
重度使用 skill 的会话会计四种 token 的费用:未缓存输入、缓存读取、缓存写入和输出。输出包括思考和工具调用参数,这就是 effort 会改变账单的原因。价格以每百万 token 的美元数计,公式为:
cost = (U x p_in + R x p_cache_read + W x p_cache_write + O x p_out) / 1,000,000
其中 U 是未缓存输入,R 是缓存读取,W 是缓存写入,O 是输出 token。下面三项成本是分开算的,这样你可以看出哪个杠杆大。
列表。 Claude Code 会把 skill 名称和描述的列表加载进上下文,让模型知道有哪些 skill,文档说每个条目合并后的文本上限为 1,536 个字符。假设你安装了 100 个 skill,平均描述长 300 个字符,那就是 30,000 个字符,按粗略的每 token 四个字符估算约 7,500 个 token(这是一个假设,不是实测值)。在一个 50 轮的会话里,假设一次缓存写入加 49 次缓存读取:Opus 5.5 为写入 7,500 x $5 = $0.0375,加上读取 367,500 x $0.20 = $0.0735,合计 $0.111。Sonnet 5.5 是一半:$0.056。放在整个 50 轮会话里,这份列表在 Opus 上大约花 11 美分。
一个被调用的 skill 正文。 取一个 4,000 token 的 SKILL.md,在一个 30 轮会话的第一轮被调用。在 Opus 5.5 上:写入 4,000 x $5 = $0.02,加上 116,000 个缓存读取 token x $0.20 = $0.0232,合计 $0.0432。在 Sonnet 5.5 上:$0.0216。如果被调用的正文长一倍,成本就翻倍,在 Opus 上约为八分半美分。在成百上千次会话里,这并非小数目,但请和下一项对比一下。
一个重度思考的轮次。 一个产出 30,000 个输出 token 的轮次(对一个困难步骤,在 high effort 加思考时并不罕见),在 Opus 5.5 上花 30,000 x $20 / 1,000,000 = $0.60,在 Sonnet 5.5 上花 $0.30。仅这一个轮次,就比任一模型上整个 50 轮的列表成本还高,也比 Opus 上一个 4,000 token skill 正文的六倍还多。
结论是算术,而不是观点:把一个 skill 从 4,000 token 精简到 2,000,在 Opus 上每个会话大约省两美分;而把一个 30,000 token 的轮次从 high effort 降到 medium,如果输出减半,就能省三十美分。精简 skill 文件,是为了清晰、也是为了压缩的缘故,而不是为了账单。把成本上的注意力花在 effort 和一个 skill 启动多少子智能体上。还有一个缓存方面的提醒:缓存条目会过期,所以空闲间隔很长的会话要重新支付写入价格,缓存时长规则见 Anthropic 的定价页。
Effort 是成本旋钮
Anthropic 把 effort 记录为一种行为信号,而不是严格的 token 预算,并说它会影响每一个输出 token,包括文本、工具调用和思考。对智能体来说,这意味着更低的 effort 也会产生更少、更简短的工具调用,而这正是长时间的 skill 运行花时间的地方。
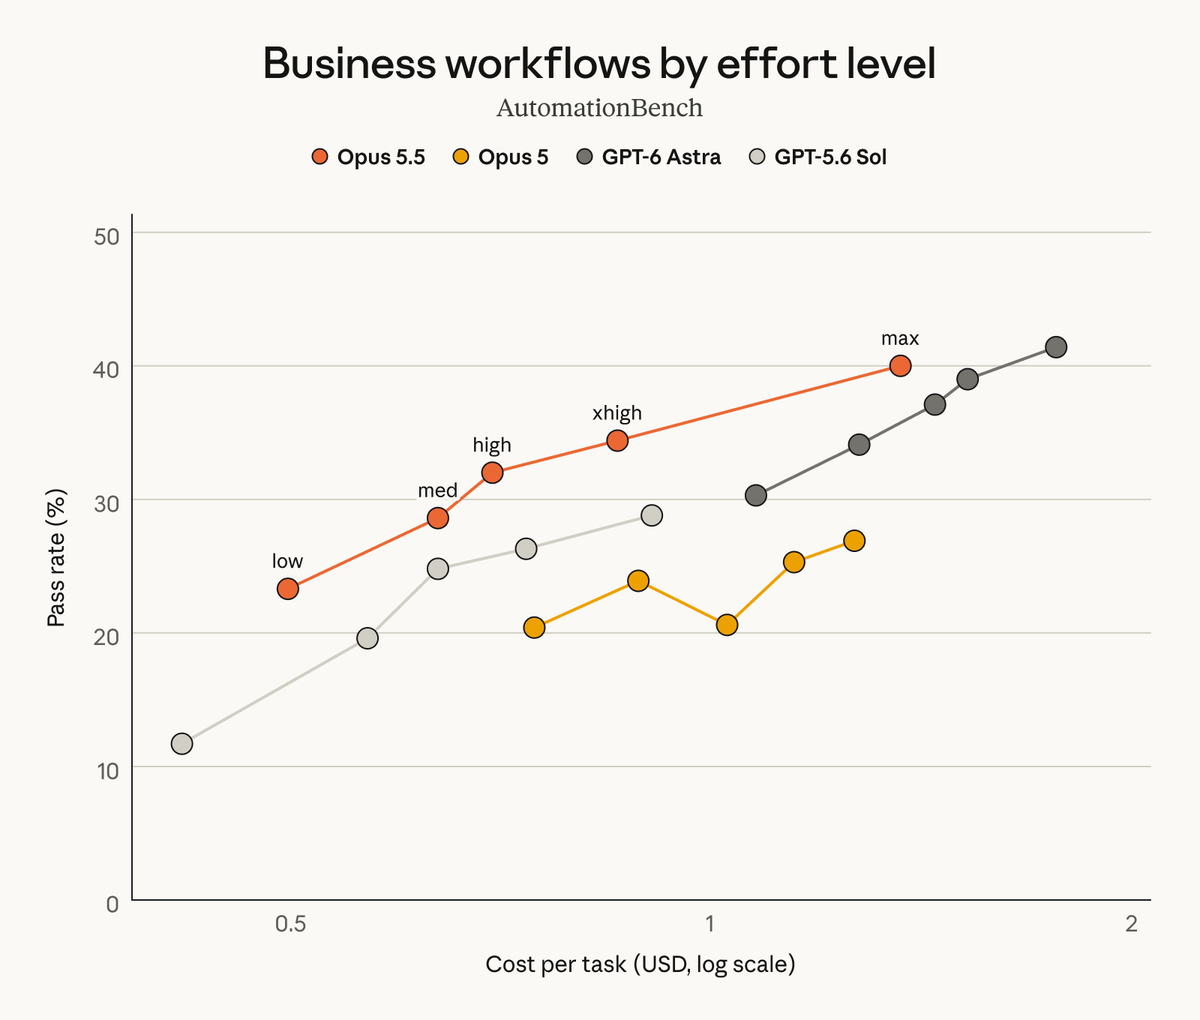
Anthropic 的 Opus 5.5 发布帖串包含了标出每档 effort 的单任务成本图表。在 AutomationBench 那张图上,从图片读取,Opus 5.5 的五个点从 low effort 时每个任务约 50 美分、通过率约 23%,到 max 时约 1.35 到 1.40 美元、通过率约 40%。这些数值是从对数坐标图上读出的近似值,而不是 Anthropic 印出的数字。它们展示了对路由有用的曲线形状:一条上升后趋于平缓的曲线,最后几档每多拿一分通过率的成本,比头几档高得多。
Anthropic 对 Sonnet 5.5 的指引很具体,也很适合 skill 工作。除非负载是智能体型或对延迟敏感,否则从 high 开始;对智能体编程和多步工具调用,需求明确的任务从 medium 开始,较难或较长的任务升到 high;只有当你自己的评测显示有提升时,才使用 xhigh 或 max。提供清晰流程的 skill,比如步骤明确的先写测试工作流,就是教科书式的“需求明确”任务;一个写着“调查并决定”的 skill 则不是。请据此路由。
两个模型也都接受按消息设置的 effort,标注为 beta 功能,它让智能体循环可以在轮次之间改变 effort,同时保留提示缓存。对于既有廉价的记账阶段、又有昂贵的推理阶段的 skill,这比把 skill 拆成两个更好,因为你只需要一个上下文和一份缓存。
按 Skill 类型路由
下表把常见的 skill 任务对应到起步的模型和 effort。这些是需要测试的起点。Anthropic 文档给出指引的地方,表中的行遵循其指引;其余是我根据价格和基准数据做的推断,并已标明。注册表链接指向本站的真实条目,你可以在路由之前先读一下每个 skill 实际在指示什么。
| Skill 任务 | 示例 skill | 起步配置 | 理由 |
|---|---|---|---|
| 把规格说明变成多步计划 | writing-plans | Opus 5.5,medium,规格含糊时升到 high | 只有一遍,错误会传导到之后每一步;推断自 Anthropic 关于“持续判断”的措辞 |
| 执行相互独立的计划任务 | subagent-driven-development | Sonnet 5.5,medium | 大量并行任务,Anthropic 建议需求明确的智能体工作用 medium |
| 先写测试的实现 | test-driven-development | Sonnet 5.5,medium | 流程明确,失败的测试给了模型一个检验标准 |
| 调试一个故障 | systematic-debugging | Sonnet 5.5,high;两次失败后升级到 Opus 5.5 | 开放但可检验;升级规则是我的推断 |
| 合并前审查 | requesting-code-review | 审查者用 high 的 Sonnet 5.5,最终裁决用 medium 的 Opus 5.5;避免 max | Cognition 关于 max effort 审查扇出的 FrontierCode 脚注 |
| 基于 Claude API 开发 | claude-api | Sonnet 5.5,medium | 有参考资料可依,需求明确 |
| 代码库搜索与总结 | Explore 风格的子智能体 | 能装下仓库地图的最便宜模型,low effort | 只读,输出向上汇总;请确认所选模型的价格 |
| 通过 API 做通宵批量任务 | Agent SDK 作业 | Opus 5.5 配合 Batch API | Batch 打五折,所以相同 token 下 Opus 的价格与 Sonnet 的标准价格持平 |
最后一行是根据定价页做的算术:Batch API 对输入和输出各打五折,Anthropic 说这个折扣可以与缓存叠加,所以在相同 token 数下,批处理的 Opus 5.5 作业与标准价格的 Sonnet 5.5 作业成本相当。它适用于异步的 API 流水线,不适用于交互式的 Claude Code 会话。
子智能体会放大一切
子智能体会启动全新的上下文。它不共享父级的缓存,所以它的第一次输入按完整写入价格计为缓存写入,并且有它自己的输出。一个启动六个子智能体的 skill,在计入父级之前,就已经把每个智能体的成本乘以六。
用一个示意性的审查扇出来说明。六个子智能体各读取 60,000 个全新上下文 token,按缓存写入价格计费,各产出 10,000 个输出 token。在 Opus 5.5 上,一个子智能体花 60,000 x $5 = $0.30 加 10,000 x $20 = $0.20,即 $0.50,所以六个共 $3.00。在 Sonnet 5.5 上,一个花 60,000 x $2.50 = $0.15 加 10,000 x $10 = $0.10,即 $0.25,所以六个共 $1.50。再加上父级的一次规划,读取 40,000 个全新 token、写出 8,000 个:Opus 上 $0.36,Sonnet 上 $0.18。
| 路由方式 | 父级规划 | 六个子智能体 | 合计 |
|---|---|---|---|
| 全部用 Opus 5.5 | $0.36 | $3.00 | $3.36 |
| 全部用 Sonnet 5.5 | $0.18 | $1.50 | $1.68 |
| Opus 规划,Sonnet 执行 | $0.36 | $1.50 | $1.86 |
混合方案比全 Sonnet 多花 18 美分,比全 Opus 少花 1.50 美元。这些 token 数是为说明而编的,重点在于结构:规划只有一遍,扇出有很多遍,所以把昂贵的模型放在只有一遍的那一步,每一块钱买到的判断力最多。
effort 也会改变这张表。如果因为更高的 effort,每个子智能体产出 25,000 个输出 token 而不是 10,000 个,一个 Sonnet 子智能体花 $0.15 + $0.25 = $0.40,六个就是 $2.40。这已经超过了前面全 Sonnet 的总额,但仍低于输出较低时的全 Opus。结论是:高 effort 的 Sonnet 扇出,成本可以逼近低 effort 的 Opus 扇出。Anthropic 对自己的图表也是这么说的:Sonnet 5.5 在较低 effort 设置下与 Opus 5.5 搭配得最好,那里每个任务更便宜;而在较高设置下,它可以在相近的成本下表现相当。
然后是质量这一面,Cognition 的脚注直接适用。FrontierCode 评分看的是维护者会不会合并这个改动,并且即使改动有益,只要超出范围也会扣分。更高的 effort 设置买来的是更多的动作,包括更多的审查子智能体和更多的编辑,而更多的动作不等于一个小而可合并的 diff。如果审查 skill 是你流水线的一部分,请限制它最多可以启动多少个审查者,并给审查者一条明确的范围指示,而不是用提高 effort 来弥补一份开放式的任务说明。
在任一模型上都稳得住的 Skill 写法
只能在一个模型上工作的 skill 是维护上的负担,因为模型别名会变。根据模型配置文档,sonnet 和 opus 别名在 Anthropic API 上解析为最新版本,在其他一些提供商上则解析为较早的版本,所以按别名固定的 skill,可能在你不知情时换了模型。下面几个习惯能让 skill 更可移植。
把不可商量的指令放在最前面。结合 skills 文档里的压缩行为和臃肿文件在长会话中的成本,skill 的第一屏应当放那些必须保留下来的规则,流程和示例可以放在后面。
描述要具体,并且把重点前置。每个条目 1,536 个字符的列表上限,适用于合并后的描述文本,不论预算如何,文档建议把关键使用场景放在最前面。含糊的描述会让模型在错误的时机调用 skill,这在两个模型上都会浪费 token。如果一个 skill 只应在你要求时才运行,disable-model-invocation: true 可以阻止 Claude 自动调用它。
把范围写成指令,而不是期望。FrontierCode 的脚注表明,超出范围的改动即使合理,也会让模型丢分。一个写着“只改动指定目录下的文件;把你想改的其他地方列出来,而不是直接改”的 skill,给了两个模型同样的边界,也让审查更容易。
把硬性要求放进 hook,而不是写在文字里。skills 文档说,如果 Claude 跳过了一条每次都必须成立的规则,这条规则就该放进 hook,因为 hook 在其事件每次发生时都会运行。这与模型无关,也去掉了一个为更强模型付费的理由。
在两个模型上都测试 skill。只在 Opus 上通过的 skill,表达的是 Opus 的价格所买下的某项要求;在 medium 的 Sonnet 上就能通过的 skill,运行次数可以多一倍而花费不变。
混合模型会话与 thinking 块
在同一个对话中跨模型路由,有一个文档中记载的细节。Anthropic 的文档说,Sonnet 5.5 能读取来自 Sonnet 5、Opus 4.8、Haiku 4.5 及更早模型的 thinking 块,但读不了 Opus 5、Opus 5.5 或任何 Fable、Mythos 模型的;而在 Claude API 上,Opus 5.5 能读取 Sonnet 5.5 的块。实际效果是:从 Sonnet 5.5 起步、再升级到 Opus 5.5 的会话保留了推理轨迹,反过来则后面几轮在没有它的情况下运行。被丢弃的块不计费,请求仍会成功,只是第二个模型在没有第一个模型推理过程的情况下起步。
所以向上升级是成本更低的交接,这适合“先用 Sonnet,失败再升级”的 skill 策略。如果一个 skill 要把一长串推理从 Opus 交给 Sonnet,请把决策总结写进消息文本里,而不要指望 thinking 块去承载它们。
对直接使用 API 的构建者,还有一个迁移细节。Opus 5.5 不允许关闭 thinking,所以为省钱而关闭 thinking 的测试框架,应当改为降低 effort。如果某个 skill 的流水线按位置选取响应内容块,它可能会出问题,因为在默认 display 设置下,Opus 5.5 的响应可能以一个空的 thinking 块开头。请按块类型来选取。Sonnet 5.5 破坏性变更的完整清单,在 AgentPedia 的姊妹文章里;本文只标出会影响 skill 流水线的两项。
独立证据,只取与本文相关的部分
Artificial Analysis 发布了智能指数 v5,并在 max effort 下覆盖了这两个模型。在基于 Cognition 以合并为导向的评分构建的编程基准上,max 档的 Opus 5.5 得 46%,max 档的 Sonnet 5.5 得 42%。在知识工作基准 AA-Briefcase 上,Sonnet 5.5 以 1812 Elo 领先所有被测模型。Artificial Analysis 还指出,Sonnet 5.5 在其两项评测上的分数来自一次预发布部署,其中有一个结构化输出 bug,Anthropic 说已修复,并预计它低估了表现。
对 skill 路由来说,有两个限制。这些是 max effort 的数字,所以对 Sonnet 价格优势最大的 medium 和 low 档位,它们什么也说明不了。而且它们衡量的是单个任务,而不是一个 skill 多步骤的遵循度。它们支持这个方向:Opus 在编程上略领先,Sonnet 在文档型工作上表现强劲;但它们并不能为你的 skill 决定一套路由策略。那需要你自己的运行数据。
论断与证据对照表
| 论断 | 来源 | 状态 |
|---|---|---|
| Opus 5.5 每百万 token $4/$20,Sonnet 5.5 为 $2/$10 | Anthropic 定价页 | 已核实,一手来源 |
| 10 月 7 日降价后,Sonnet 5.5 缓存读取为 $0.10 | Anthropic 帖子与定价页 | 已核实,一手来源 |
| 两个模型都接受五档 effort,从 low 到 max | Anthropic effort 文档 | 已核实,一手来源 |
| 在 API 上 Opus 5.5 默认 medium,Sonnet 5.5 默认 high | Anthropic effort 文档 | 已核实,一手来源 |
子智能体的 model 和 effort frontmatter,并有文档记载的优先级 | Claude Code 子智能体文档 | 已核实,一手来源 |
Skill 的 model 和 effort frontmatter 存在,并在当前轮次生效 | Claude Code skills 文档 | 已核实,一手来源;未测试 |
opusplan 在规划模式用 Opus,随后用 Sonnet | Claude Code 模型配置文档 | 已核实,一手来源 |
| Sonnet 在 max 的 FrontierCode 得分低于 xhigh,原因是审查 skill 的扇出 | Anthropic Sonnet 5.5 页面的脚注 | 厂商自报,合作方检查 |
| Opus 5.5 在 FrontierCode 领先,54.4 对 52.1(xhigh)对 46.2(max) | Anthropic 的 Sonnet 5.5 页面 | 厂商自报 |
| 在 max 的合并评分编程基准上,Opus 5.5 为 46%,Sonnet 5.5 为 42% | Artificial Analysis 指数 v5 | 独立来源 |
| 调用 skill 时一次性加载正文并留在上下文中 | Claude Code skills 文档 | 已核实,一手来源 |
| Sonnet 比 Opus 更会遵循 skill | 无 | 未证实;请自行测试 |
| Skill 文件的大小主导会话成本 | 上文的算术 | 对典型大小而言不成立;effort 和扇出才是主导 |
运行你自己的路由实验
上面的成本算术只是示意,请换成你自己的数据。挑三个你实际在用的 skill:一个规划类、一个执行类、一个审查类。对每个 skill,定义一组固定的十个任务,结果已知良好,难易搭配。每个任务在四种配置下运行:medium 的 Sonnet 5.5、high 的 Sonnet 5.5、medium 的 Opus 5.5 和 high 的 Opus 5.5。记录结果是否通过你的检查、审查者是否会不加修改就合并、启动的子智能体数量、总输出 token 数,以及实际耗时。然后用本文的公式计算每个被接受改动的成本,这才是重要的数字,而不是每次尝试的成本。
有两条规则能让实验保持诚实。每种配置都在干净的分支上运行,这样没有模型会看到先前的尝试。还要比较启动的子智能体数量,因为 Cognition 的脚注表明,更高的 effort 可能会改变 skill 的行为,而不只是模型思考的时间。如果 high effort 启动的审查者是 medium 的两倍,而合并率没有改善,你就找到了该加进 skill 里的一个上限。
xhigh 和 max 只加在困难任务上,并且只在 high 显示出提升的地方。Anthropic 自己的指引也说,只有当你的评测显示质量有提升时才使用这些档位。等你有了一张按 skill 划分的“每个被接受改动成本”的表,就把它固化下来:在 skill 的 frontmatter 里,或在每个 skill 所委派的子智能体上设置 model 和 effort,交互式规划使用 opusplan,并把会话默认值留在 medium 的 Sonnet 5.5。想了解模型驱动的智能体负载的更多背景,以及另一对前沿模型的成本分析实例,请读 GPT-6.1 Sol 智能体负载拆解;想看面向新模型发布的记分卡式方法,请看面向智能体构建者的 Muse Wonder 记分卡。
这两支视频都是 Anthropic 在 Claude YouTube 频道发布的官方产品介绍。本文的数字取自书面页面和文档,因为脚注都在那里,视频里没有。
局限
本文继承了其来源的局限。Anthropic 的每个基准都是厂商自报,其中包括 AutomationBench 在内的若干项是合作方基准。Anthropic 表中两个模型所在的行,并不总是在同一档 effort 下,Terminal-Bench 4.0 一行也没有说明 Sonnet 运行时的 effort。几分之内的差异,都落在所给的标准误差之内。
针对 skill 的建议有一部分是推断。Anthropic 没有为任一模型发布过 skill 遵循度的基准,所以路由表背后的理由建立在文档记载的行为、价格算术和 FrontierCode 脚注上,这里没有任何内容是在 skill 负载上实测的。我没有用任何一个模型去运行这些 skill。每 token 四个字符的估计是经验法则,不是分词器的计数。Sonnet 5.5 在 Claude Code 里的默认 effort,在 Anthropic 的两个页面上说法不同,所以请在你自己的会话里用 /effort 确认。Claude Code 更新很快,在依赖任何 frontmatter 字段之前,请查看当前的 skills 和子智能体页面。我没有亲自测试 skill 级别的 model 或 effort frontmatter;我只是在转述文档所说的内容。
结论
把 Opus 5.5 用在决定“造什么”和“好不好”的步骤上,把 Sonnet 5.5 用在要重复很多次的“造”的步骤上。有意识地设置 effort:需求明确的工作用 medium,困难或开放式的工作用 high,把 xhigh 和 max 当作需要测算回报的实验。限制审查类 skill 的子智能体扇出,因为 Anthropic 自己的脚注指出,那里正是更高 effort 不再有帮助的地方。不要仅仅为了成本去精简 SKILL.md 文件;精简它们,是为了让重要规则放在最前面,并在压缩之后仍然留存。
真正的未知数是 skill 遵循度。在有人为这些模型发布 skill 遵循度基准之前,路由表只是一个由价格、effort 指引和一条很有启发的脚注构建出来的假设。在改动团队默认值之前,请先在你最常用的三个 skill 上跑一遍上面的十任务实验。
常见问题
一个 skill 应该跑在 Opus 5.5 还是 Sonnet 5.5 上? 执行类 skill 用 medium effort 的 Sonnet 5.5,规划或最终审查的步骤用 Opus 5.5。Claude Code 的 opusplan 模式会按规划模式与执行模式自动应用这种分工。在把它当作规则之前,请先测试你自己的 skill,因为 Anthropic 没有为任一模型发布 skill 遵循度的基准。
怎样为子智能体设置模型和 effort? 在子智能体的 frontmatter 里,把 model 设为别名、完整模型 ID 或 inherit,把 effort 设为 low、medium、high、xhigh 或 max。effort 字段会覆盖会话级别,但不会覆盖环境变量 CLAUDE_CODE_EFFORT_LEVEL。模型的解析顺序是:单次调用参数、frontmatter 字段、CLAUDE_CODE_SUBAGENT_MODEL,最后是主对话的模型。
Effort 档位叫什么,默认值是什么? API 的 effort 参数在 Opus 5.5 和 Sonnet 5.5 上都接受 low、medium、high、xhigh 和 max。在 API 上,Opus 5.5 默认 medium,Sonnet 5.5 默认 high。Anthropic 的 Sonnet 页面说,在 Claude Code 及其应用中默认是 Medium,这与前一代 Sonnet 的文档措辞不同,所以请用 /effort 确认。
更大的 SKILL.md 会让 Claude Code 更贵吗? 略贵一点。被调用的 skill 正文会留在上下文里,在之后的轮次按缓存读取计费。对一个 30 轮会话中 4,000 token 的正文,上面的算术给出 Opus 5.5 约 $0.043、Sonnet 5.5 约 $0.022。而单个 30,000 token 的高 effort 输出轮次在 Opus 上花 $0.60,所以 effort 和子智能体数量比文件大小更重要。
对同一次 skill 运行,Sonnet 5.5 比 Opus 5.5 便宜多少? Sonnet 的每项价格都是 Opus 的一半,所以相同的 token 数成本减半。如果 Sonnet 用了两倍的 token,成本就相等。在上面六个子智能体的例子里,Sonnet 花 $1.68,Opus 花 $3.36,而“Opus 规划、Sonnet 执行”的混合路由花 $1.86。其中的 token 数是示意性的。
为什么 Sonnet 5.5 在 FrontierCode 上 max effort 的得分低于 xhigh? Anthropic 的脚注说,在 max 时,Sonnet 5.5 更频繁地运行 Claude Code 的代码审查 skill,它会把一次审查拆给许多子智能体。在 Cognition 检查的两个案例里,这导致了超时,或超出任务范围的编辑,而 FrontierCode 会对此扣分。结论是:更高的 effort 可能意味着更多的动作,不一定意味着更小的可合并改动。
会话中途从 Sonnet 5.5 切到 Opus 5.5,会丢失推理轨迹吗? 从 Sonnet 5.5 切到 Opus 5.5,在 Claude API 上会保留推理轨迹,因为 Opus 5.5 能读取 Sonnet 5.5 的 thinking 块。反过来,Sonnet 5.5 读不了 Opus 5.5 的 thinking 块,所以后面的轮次会在没有它的情况下运行。请求仍会成功,被丢弃的块也不计费。
来源
核对于 2026 年 10 月 28 日。
Anthropic,一手来源
- Claude Opus 5.5:定价、基准表、发布时的论断
- Claude Sonnet 5.5:定价、含 Opus 5.5 一列的基准表、FrontierCode 脚注
- 定价:每 token 费率、Batch API、缓存定价
- Effort 参数:档位、默认值、各模型的指引
- What's new in Sonnet 5.5:破坏性变更、thinking 块兼容性
- Claude Code:子智能体:
model与effortfrontmatter、解析顺序 - Claude Code:模型配置:别名、
opusplan、effort 环境变量 - Claude Code:skills:skill 加载、列表上限、压缩行为、
model与effortfrontmatter - X 上的 @claudeai:Opus 5.5 与 Sonnet 5.5 的发布帖串、缓存读取降价
- Introducing Claude Opus 5.5(YouTube)与 Introducing Claude Sonnet 5.5(YouTube)
独立来源
本站


