逐行拆解 Muse Wonder:Meta 前沿模型证明了什么,又没有证明什么
Meta 的 Muse Wonder 在自家 14 行成绩单中领先 7 行、落后 Claude Opus 5.5 共 6 行。逐行审视基准测试、价格、可用性与模型卡。
Agent Skills
逐行拆解 Muse Wonder:Meta 的前沿模型证明了什么,又没有证明什么
2026 年 10 月 12 日,马克·扎克伯格发了一张基准测试表和一句话:“Introducing Muse Wonder, our new family of frontier models with state of the art performance for personal and professional agentic work.”(介绍 Muse Wonder,我们全新的前沿模型家族,在个人与专业智能体工作上达到业界领先水平。)这张表把 Meta 的两个新模型 Muse Wonder 和 Muse Wonder Full,与 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5 放在 14 行测试里对比。粗看像是一场横扫;逐行细读,结论更有用:这个模型在七行上确实第一,在另外几行上稳居第二,而在六行上明显落后于 Claude Opus 5.5。
本文逐行审视这张成绩单。我们把三类信息分开:Meta 自己发布的数字(厂商自报)、外部机构实际测得的数字(Meta 模型卡里点名的结果来源有 Artificial Analysis、Datacurve、Abundant AI、Vals AI 和 Surge),以及目前还没有任何外部人员能够测试的部分。同时我们也把开发者最关心的事实钉死:今天能调用什么、多少钱、哪个套餐能用哪个模型,以及安全文档到底写了什么。
Meta 实际发布了什么
扎克伯格的发布是 X 上的一个五条帖子的串,发于 UTC 16:55。首条帖子以图片形式附带基准测试表:
第二条帖子附有一段视频,称距离启动 Meta 超级智能实验室“just over a year”(刚过一年),Muse Spark “was our first family of models”(是我们的第一个模型家族),而 Muse Wonder 是“a much larger and more advanced class of models that brings us to the frontier”(规模大得多、更先进的一类模型,把我们带到了前沿)。它点出了两个模型:用于“fast frontier performance”(快速的前沿性能)的 Muse Wonder,以及代表模型完整版本的 Muse Wonder Full。
访问方式分散在这个帖子串、research.meta.ai 的官方博客和 Meta 的开发者页面里,三者并不完全一致,所以值得单独列出:
| 模型 | 发布时的可用渠道 | 来源 |
|---|---|---|
| Muse Wonder | 今天即可通过 Meta Model API 和 Muse Code 使用;消费级 Muse 产品“即将”支持,订阅用户优先 | Meta 研究博客 |
| Muse Wonder Full | 今天面向 Muse Code 订阅用户;Power Usage 和 Maximum Usage 套餐 | Meta 研究博客;developer.meta.com |
| 两者 | “即将”接入 Meta 的其他产品 | 扎克伯格帖子串 |
有一处细节:扎克伯格的第三条帖子说“You can use Muse Wonder to power your Muse by subscribing today”(今天订阅即可用 Muse Wonder 驱动你的 Muse),而研究博客说 Muse Wonder“will soon power experiences in Muse”(即将为 Muse 中的体验提供动力)。如果“订阅”指的是 Muse Code 订阅,两句话可以同时成立,但帖子串没有说明,而且我没有找到消费级 Muse 订阅的公开价格。如果你把其中一句读成“Muse 应用现在就能用”,博客并不支持这个理解。
博客把这对模型描述为“the next step on our scaling ladder”(我们扩展阶梯上的下一步),把“Active Memory”(主动记忆)和“Active Focus”(主动专注)作为定义这个系列的两个概念,并表示两个模型都“trained at our gigawatt-scale Prometheus data center”(在我们的吉瓦级 Prometheus 数据中心训练)。Meta 还称,14 个月前启动了对 AI 工作的“ground-up overhaul”(从头改造),而这次改造的第一个模型家族 Muse Spark 于 2026 年 4 月 8 日发布。
大约七分钟后,Meta 的研究账号发了自己的帖子串,重复了可用渠道的划分,并用平实的语言描述了这两个核心理念:
Alexandr Wang 当天下午从自己的账号发了一条口气更强的帖子。他写道“muse wonder is the best model in the world for personal agents and professional agents”(muse wonder 是世界上最适合个人智能体和专业智能体的模型)。这比表格所能支持的结论更强,本文后面的审视会说明这种差别为何重要:
逐行成绩单
下面是已发布的表格,并标出每行的最高者。所有数字均为 Meta 自报。各列依次为 Muse Wonder Full (max)、Muse Wonder (max)、Claude Fable 5.1 (max)、GPT-6 Astra (max) 和 Claude Opus 5.5 (max)。我读取了帖子里的图片,并与 Meta 开发者页面列出的数字做了交叉核对;凡是页面文本中能看到的单元格,两者一致。开发者页面文本缺少 Fable 5.1 和 GPT-6 Astra 的 OSWorld 单元格,所以这四个数字(80.7/43.1 和 75.8/34.3)仅来自我对图片的读取,三次读取中有两次一致。
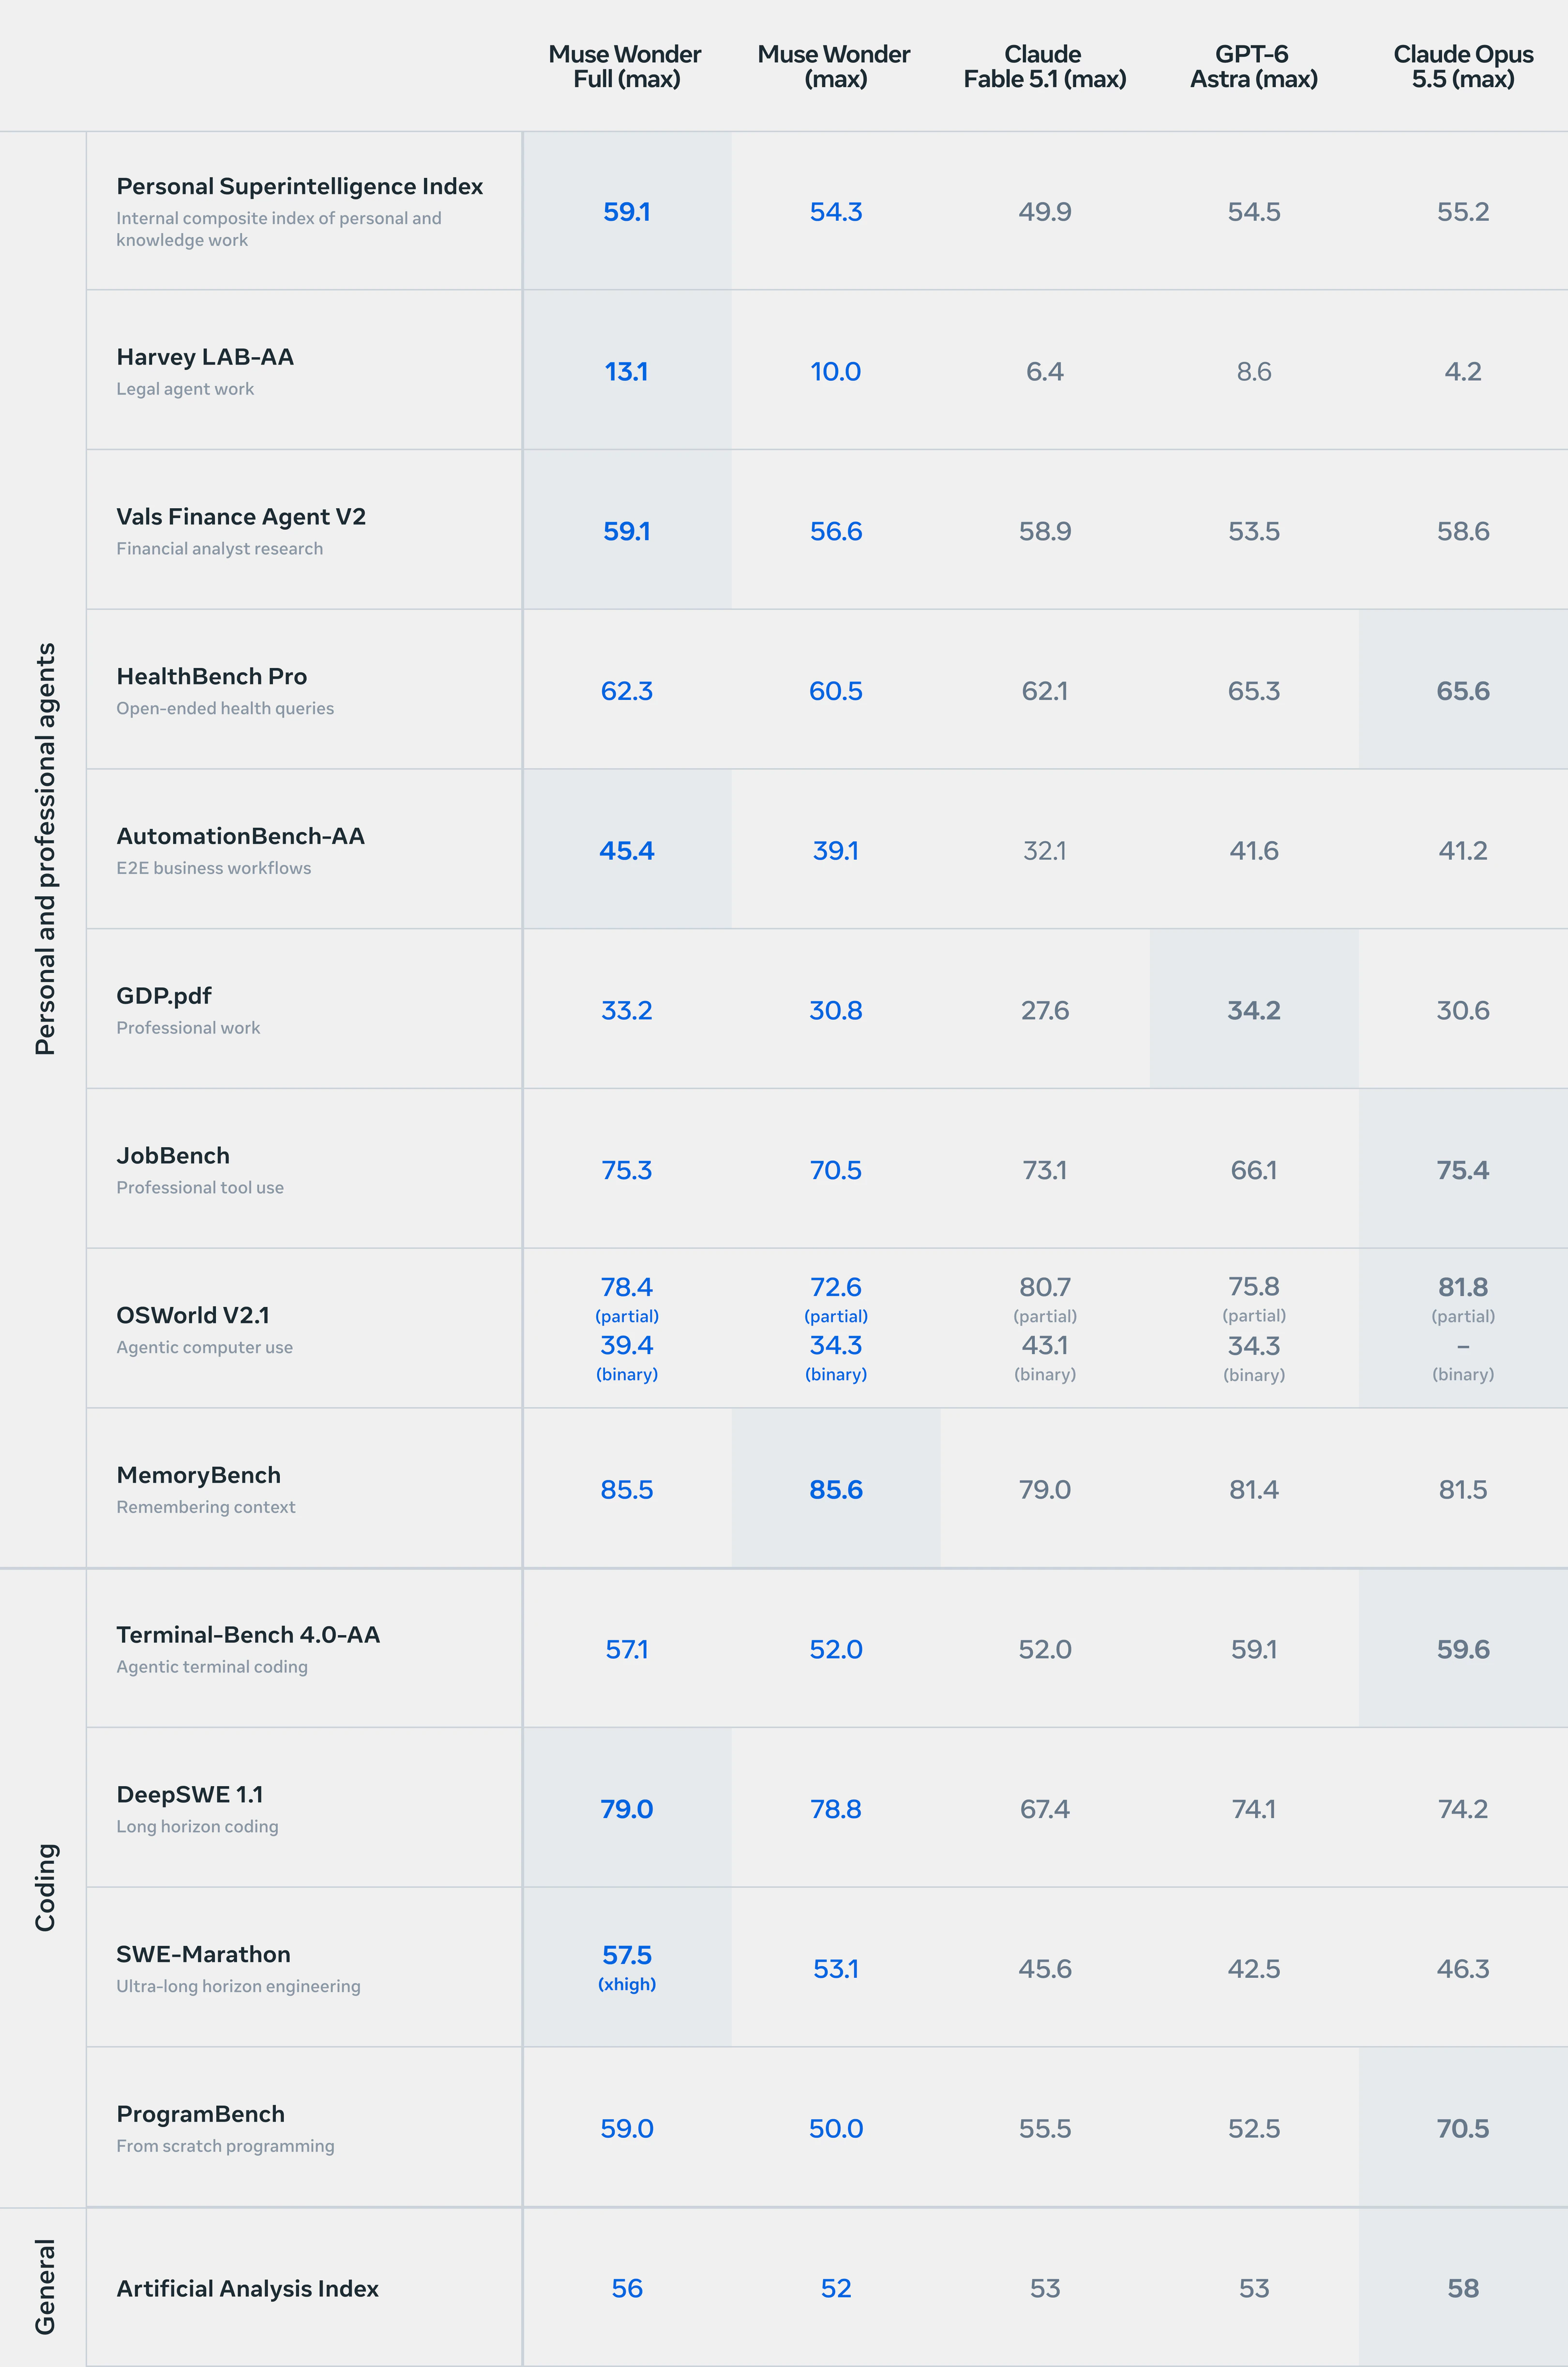
| 行 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 | 领先者 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index(内部) | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 | Wonder Full |
| Harvey LAB-AA(法律智能体工作) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 | Wonder Full |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 | Wonder Full |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 | Opus 5.5 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 | Wonder Full |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 | GPT-6 Astra |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 | Opus 5.5 |
| OSWorld V2.1,partial(部分得分) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 | Opus 5.5 |
| OSWorld V2.1,binary(严格通过) | 39.4 | 34.3 | 43.1 | 34.3 | 未报告 | Fable 5.1 |
| MemoryBench(内部) | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 | Wonder |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 | Opus 5.5 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 | Wonder Full |
| SWE-Marathon | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 | Wonder Full |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 | Opus 5.5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 | Opus 5.5 |
统计结果:Muse 模型在 14 个基准行中的七行领先(Personal Superintelligence Index、Harvey LAB-AA、Vals Finance Agent V2、AutomationBench-AA、MemoryBench、DeepSWE、SWE-Marathon)。Claude Opus 5.5 领先六行(HealthBench Pro、JobBench、OSWorld V2.1 partial、Terminal-Bench、ProgramBench 和 Artificial Analysis Index)。GPT-6 Astra 领先 GDP.pdf。Claude Fable 5.1 只领先 OSWorld 的 binary 子指标,而且这还要附带说明:Opus 5.5 没有可比较的 binary 数字。(在这个统计中,我把 OSWorld 算作一个基准行、两项指标;上表为便于阅读把它拆成了两行。)
其中有三处差距很小,不应当读成“胜出”。JobBench 是 Opus 75.4 对 Wonder Full 75.3。Vals Finance Agent V2 是 Wonder Full 59.1 对 Fable 58.9。在 OSWorld 的 partial 指标上,Wonder Full 比领先者低 3.4 分,在 binary 上低 3.7 分。在只有几十个任务的基准上,差一两分之一分是平手,不是结果。例如按 Meta 模型卡所述,JobBench 含 65 个任务,因此在对评分细则取平均之前,一个任务大约相当于 1.5 分的原始准确率。
领先幅度大的地方
最突出的差距出现在长周期软件工作,以及法律和智能体工作流任务上:
- DeepSWE 1.1: Wonder Full 79.0,Wonder 78.8,而 Opus 5.5 为 74.2,GPT-6 Astra 为 74.1,Fable 5.1 为 67.4。对最强对手的领先约五分,且两个 Muse 模型都越过了这条线。模型卡称,成绩单对 Muse 模型和 Opus 使用 Datacurve 的第三方结果,对 GPT-6 Astra 使用 OpenAI 厂商自报的数字,对 Fable 使用 Anthropic 系统卡中的数字。DeepSWE 被描述为覆盖 91 个仓库、五种语言的 113 个任务,由手写的功能测试和回归测试评分。
- SWE-Marathon: Wonder Full 57.5(按 xhigh 推理强度报告),Wonder 53.1,而 Opus 5.5 为 46.3,Fable 5.1 为 45.6,GPT-6 Astra 为 42.5。这是表中绝对差距最大的一行。Meta 的模型卡对其中的代价写得异常直接:所有模型的结果来源都是 Abundant AI,但 GPT-6 Astra 和 Fable 5.1 的排行榜条目分别用 Codex 和 Claude Code 生成,所以“this row is not a controlled common-harness comparison”(这一行不是统一框架下的受控对比)。
- Harvey LAB-AA: Wonder Full 13.1,Wonder 10.0,其他模型分别为 8.6、6.4 和 4.2。绝对数字很低,因为这个指标很严格:交付物满足全部标准并通过幻觉检查的法律任务所占比例。Wonder Full 相对 GPT-6 Astra 高出约 50%,但 13.1% 的通过率仍然意味着大多数法律工作成果至少违反一条标准。
- AutomationBench-AA: Wonder Full 45.4,对比 GPT-6 Astra 的 41.6。领先是真实的,但幅度有限。
由 Meta 自建的行需要单独说明。Personal Superintelligence Index 是由七项评测组成的内部综合指标(Agents' Last Exam、AutomationBench-AA、FocusBench、JobBench、GDP.pdf、VBT 和 DRACO),MemoryBench 和 FocusBench 也是内部基准。Wonder Full 以 59.1 对 55.2 领先综合指标。MemoryBench 是 Meta 自己的测试,考察在 64K 到 100K token、含干扰项和相互冲突的更新信息的对话中回忆事实;Wonder 的 85.6 和 Wonder Full 的 85.5 比第三名(81.5)高出约四分。这些结果看起来合理,也与产品主张一致。但它们同样是 Meta 设计、由 LLM 评审打分、且没有外部复现就发布的基准。
领先不存在的地方
表的另一侧,通用能力和终端编码这些行归 Claude Opus 5.5:
- Artificial Analysis Intelligence Index: Opus 58,Wonder Full 56,Fable 5.1 和 GPT-6 Astra 为 53,Wonder 52。这是表中唯一完全由外部机构计算的一行,它把 Meta 的旗舰排在厂商自己图表的第二位。
- Terminal-Bench 4.0-AA: Opus 59.6 和 Astra 59.1,领先 Wonder Full 的 57.1。Wonder 为 52.0,与 Fable 5.1 持平。
- ProgramBench: Opus 70.5 对 Wonder Full 的 59.0,差 11.5 分。这是表中最大的落后幅度,而且该基准测试的是在断网环境下从零重建完整程序。这一行所有被比较的模型都使用 mini-swe-agent,因此它是表中最干净的编码对比。
- HealthBench Pro: Opus 65.6 和 Astra 65.3,对比 Wonder Full 的 62.3。这一点很重要,因为 Meta 自己的帖子把健康列为模型具备“specialized knowledge”(专业知识)的领域之一。Opus 和 Fable 的数字是 Anthropic 报告的系统卡数据,其他模型在统一的内部框架中运行。
- OSWorld V2.1: Opus 在 partial 指标上以 81.8 领先,Fable 在严格的 binary 指标上以 43.1 领先。Wonder Full 为 78.4 partial 和 39.4 binary。模型卡把 OSWorld V2.1 描述为完整 Ubuntu 桌面上的 108 个真实工作流,在统一的内部框架中运行,以 partial 奖励为主要指标。
诚实的总结是:Muse Wonder 是前沿模型,意思是它与市场顶端具有竞争力,并且在特定一块上领先:长周期软件项目、记忆,以及一组智能体式的业务、法律和金融任务。这比“世界最强模型”窄,但对开发者而言更有意思,因为它告诉你第一轮评测该把目标放在哪里。
这张表是怎么做出来的,为什么重要
Meta 的模型卡在方法论上比大多数厂商发布更清楚,其中有几句话会改变你对这张表的读法。
第一,得分选择。模型卡写道:“where a comparable third-party or provider-reported result exists, we use it; otherwise we use the highest of our internally validated run, self-reported score, or official leaderboard score.”(凡有可比的第三方或厂商自报结果,就用它;否则取内部验证运行、自报分数或官方排行榜分数中的最高者。)对营销表格来说,每行取可得分数的最大值是合理的惯例,但它会让每个单元格偏高;而且这一做法同样适用于竞争对手,所以并不明显偏向一方。不过这意味着各单元格来自不同的来源,下面的备注因此重要。
第二,竞品运行是尽力而为。“Internally generated competitor runs use common settings where practical but remain best-effort: prompts, tools, and runtime may not be optimally tuned for proprietary models.”(内部生成的竞品运行在可行时使用通用设置,但仍是尽力而为:提示词、工具和运行时对专有模型未必调到最优。)这是标准免责声明,也是你应当自己搭测试框架的最重要原因。
第三,框架混用。“For controlled internal coding comparisons, every model uses the same benchmark-specific harness. External coding results retain the harness or agent product used by the reporting vendor or model provider.”(在受控的内部编码对比中,每个模型使用相同的、针对基准的框架。外部编码结果保留报告厂商或模型提供方所用的框架或智能体产品。)因此 ProgramBench 是受控对比,SWE-Marathon 不是,而 DeepSWE 对三个模型使用第三方运行,对另外两个使用厂商自报数字。
第四,拒答计入失分。“Model refusals receive zero credit and remain in the denominator rather than being dropped.”(模型拒答得零分,并保留在分母中,而不是被剔除。)这是偏向严谨的公平性选择。
第五,推理强度。所有结果都是“generated with max reasoning effort”(以最高推理强度生成),Wonder Full 在 SWE-Marathon 上按 xhigh 报告。如果你以默认强度运行这些模型,预计分数会更低,成本也更低。
最后,表中的竞品集合只是一个快照。四个对比模型是 Meta 自己选的。明显缺席的有 Gemini 4 Argon(Artificial Analysis 将其列为 53)和 GPT-6.1 Sol(列为 52)。我们此前关于 Gemini 4 Argon 和 GPT-6.1 Sol 的解读覆盖了这些模型,而独立指数把它们列为 53 和 52,与 Muse Wonder(52)相差不到一分,比 Muse Wonder Full(56)低几分。
独立测量怎么说
Artificial Analysis 是独立的基准测试机构,Meta 把它的指数用作“General”(通用)一行。它在扎克伯格的帖子串之后约 30 分钟发布了自己的评测:
这是第三方帖子,不是 Meta 的来源,里面有发布周最有用的数字:
- Intelligence Index v4.3: Muse Wonder Full 56,Muse Wonder 52,对比 Muse Spark 1.3 的 48,分别提高 8 分和 4 分,“with a release gap of only 6 weeks”(发布间隔只有 6 周)。
- Artificial Analysis 给出的最大提升: Wonder Full 的 Terminal-Bench 4.0 从 33% 升到 57%(Wonder 为 52%),GDPval-AA v2.1 从 1681 升到 1857 Elo,AA-Briefcase 从 1581 升到 1729 Elo。
- 前三名: Wonder Full 在十项指数评测中的六项进入前三,以 33% 小幅领先 GDP.pdf,在 GDPval-AA 排第二,并以 33% 登顶 CritPt 排行榜。
- token 使用量: 两个模型每个指数任务都使用约 54k 输出 token,比 Muse Spark 1.3 的 60k 降低约 10%;低于 Gemini 4 Argon(62k)和 Fable 5.1(78k),高于 GPT-6.1 Sol(38k)和 GPT-6 Astra(27k)。
- 单任务成本: Wonder 为 $4.52,对比 Fable 5.1 的 $7.63、Opus 5.5 的 $5.98 和 Sonnet 5.5 的 $5.46,但高于 GPT-6 Astra($3.26)、Gemini 4 Argon($1.99)、GPT-6.1 Sol($0.72)和 Muse Spark 1.3($1.60)。Artificial Analysis 认为,由于每个任务的输入 token 用量高达 7.69M,这个成本“higher than most similarly intelligent models”(高于大多数智能水平相近的模型)。
- 编码智能体: 在 Muse Code 中以最高强度运行,Wonder Full 在 Artificial Analysis Coding Agents Index 上得 68,与运行 Sonnet 5.5 的 Claude Code(68)持平,领先运行 Opus 5.5 的 Claude Code(66)。Wonder 得 63。使用 Muse Spark 1.3 的 Muse Code 得 54。
这份独立证据有两点限制。Artificial Analysis 在其模型页面把 Wonder Full 标为“No publicly available API”(无公开 API),所以它对 Wonder Full 的数字来自 Muse Code 产品,而不是原始模型端点,也就无法为它设定每 token 价格(用它的话说是“Per-token pricing is not currently available for Muse Wonder Full”)。而且这些都是发布当天的数字,单次评测只是一个点估计。
有一处差异我无法调和。对于 AutomationBench-AA,Meta 的表中 Wonder Full 为 45.4,Wonder 为 39.1,而 Artificial Analysis 的帖子给出 Wonder Full 为 71%,Wonder 从 58% 升到 68%。Meta 的模型卡把主要指标描述为严格的 pass@1,即通过全部终态断言的工作流所占比例;Artificial Analysis 的帖子没有说明它引用的是哪个变体。两个来源都没有解释这个差距,我也无法告诉你哪个数字与哪个可比。如果你要引用这次发布的 AutomationBench,请连同定义一起引用来源。
Active Memory 与 Active Focus:这些主张是什么
Meta 围绕两个有名字的能力来定位这个模型。博客里都有定义,但两者目前都还不是有文档的独立发布功能。
Active Memory 被描述为“carrying important context about you across conversations and actively retrieving the details relevant to the task at hand”(跨对话携带你的重要上下文,并主动检索与手头任务相关的细节)。在发布视频的字幕里,一位研究员说团队投入了“a tremendous amount of effort into making sure that our model can remember what's important to you over days, weeks, months, and beyond”(大量精力,确保模型能在数天、数周、数月乃至更久的时间里记住对你重要的事)。唯一的量化证据是 MemoryBench,如前所述,它是在极长的单次对话(64K 到 100K token)内部做回忆的内部测试,而不是跨会话持久化记忆。这个区别很重要。该基准衡量的是模型能否在干扰项中找到并正确更新一个事实,这属于长上下文能力。产品层面的主张是跨数周记住你,这需要一个持久化层,而模型卡和开发者页面都没有描述。在我读到的开发者页面上,该模型被列为 1M token 上下文窗口,我没有找到任何记忆 API 或持久化功能的说明。如果你今天要自己构建持久记忆,架构问题与以前相同;我们的 agent-memory-mcp 注册表条目是对比各种方案的合理起点。
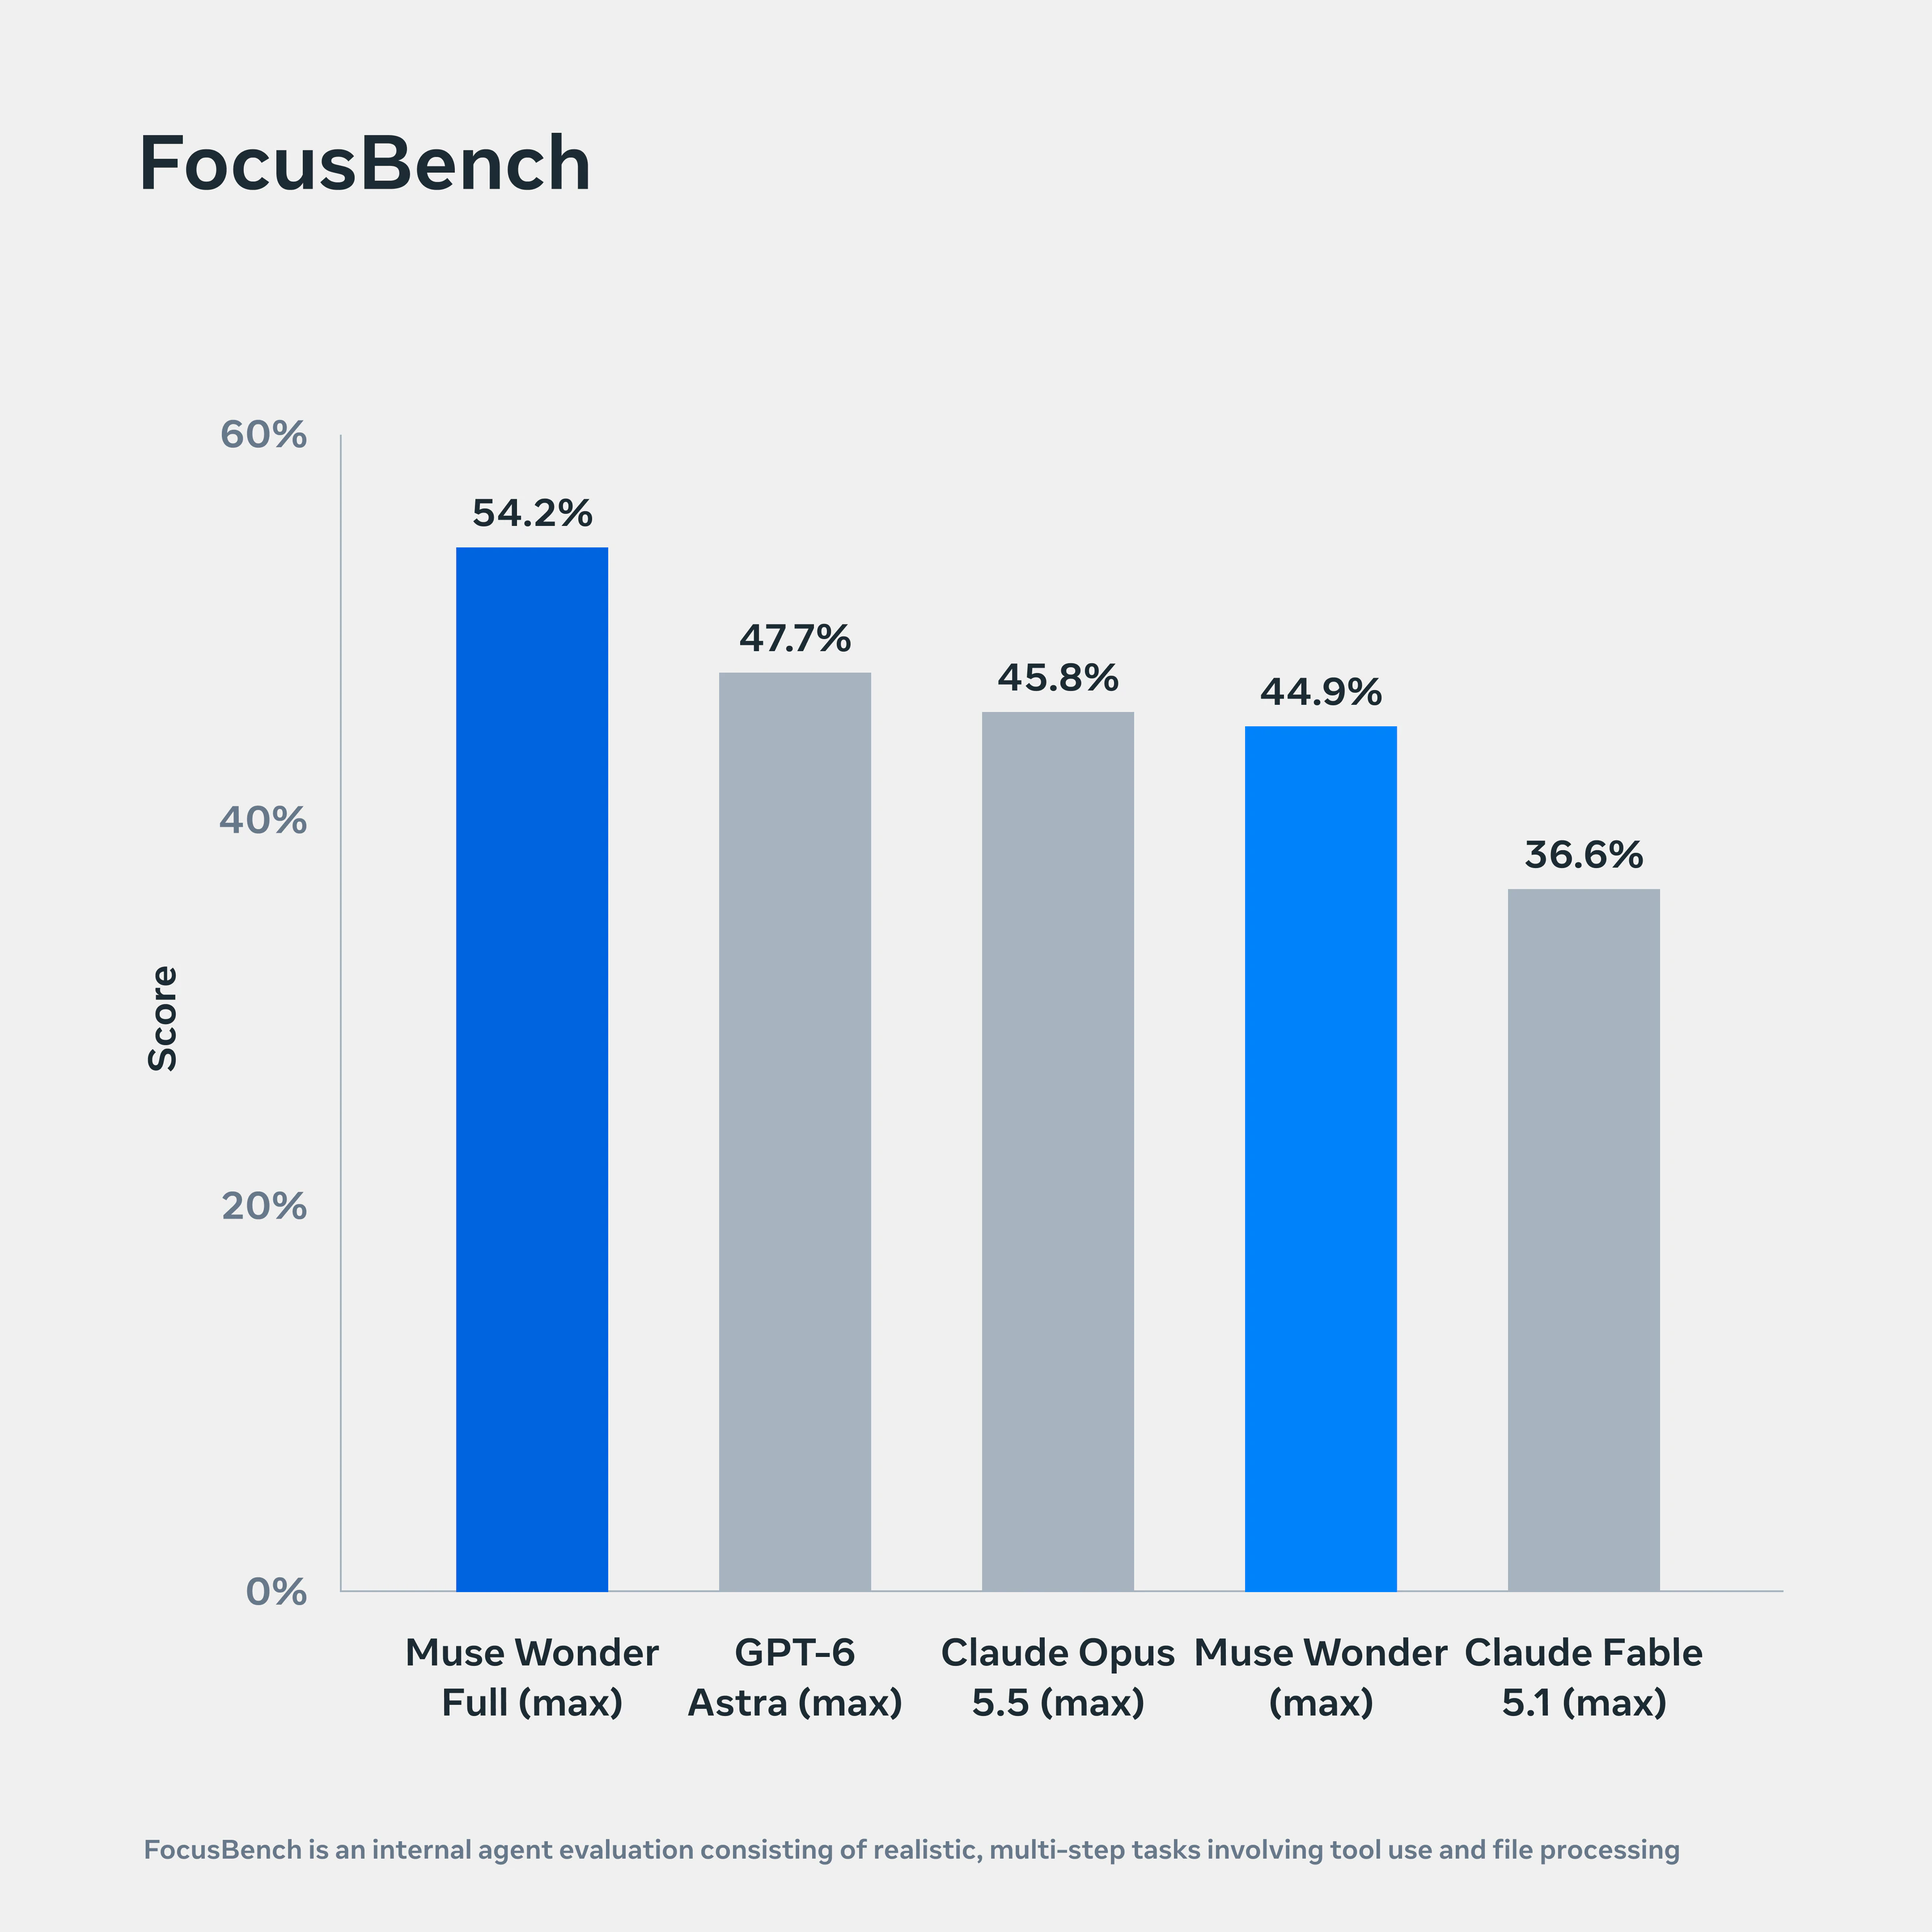
Active Focus 被描述为“how Muse Wonder continues working toward a challenging goal: trying alternative approaches, working through blockers, and adapting to new information”(Muse Wonder 如何持续朝着有挑战的目标工作:尝试替代方案、处理阻塞,并适应新信息),并在“when needed”(需要时)请求澄清,在“before taking important actions”(采取重要行动之前)确认。Meta 通过 FocusBench(内部;被描述为覆盖住房、旅行、IT 和金融的个人智能体任务)和 SWE-Marathon 来评估。FocusBench 图表显示了一个值得注意的分化结果:Wonder Full 54.2%,GPT-6 Astra 47.7%,Opus 5.5 45.8%,Wonder 44.9%,Fable 5.1 36.6%。便宜的那个模型排第四。不论 Active Focus 是什么,它在 Full 版本中都比在标准版中强得多。
发布视频让产品意图变得具体。一位研究员说她用这个模型来“research all the new listings from multiple sources every day, and then the model will just contact the owner on behalf of me”(每天从多个来源调研所有新房源,然后模型直接代表我联系房东)。这恰好是会引发下文安全问题的那类能力:一个代表你行事、联系第三方并持有私人上下文的智能体。
泛化:“刷榜”之问
博客里我觉得最有意思的一节,是正面回应显而易见的质疑。Meta 写道:“complaints of ‘benchmaxxing’ and praise for ‘big model smell’ both get at: a breadth of capability that popular benchmarks in a few domains can't fully capture.”(对“刷榜”的抱怨和对“大模型味”的赞美,指的都是同一件事:热门基准在少数领域里无法完全捕捉的广泛能力。)
它的测试是:对 Muse Spark 1.3 和 Muse Wonder Full,在多个推理强度设置下,绘制后训练所针对任务(“in-distribution”,分布内)上的表现,对比后训练未针对任务(“out-of-distribution”,分布外)上的表现。我查看了这张图。每个模型有四个点。Muse Spark 1.3 从大约 46% 分布内、17% 分布外,升到约 59% 和 30%;Muse Wonder Full 从大约 49% 和 31%,升到约 71% 和 49%(这是我对图的读取,不是已发布的数值)。虚线趋势线大致平行,一个标注为“Extra Out-of-Distribution Performance”(额外的分布外表现)的箭头标出两条线之间的垂直差距。
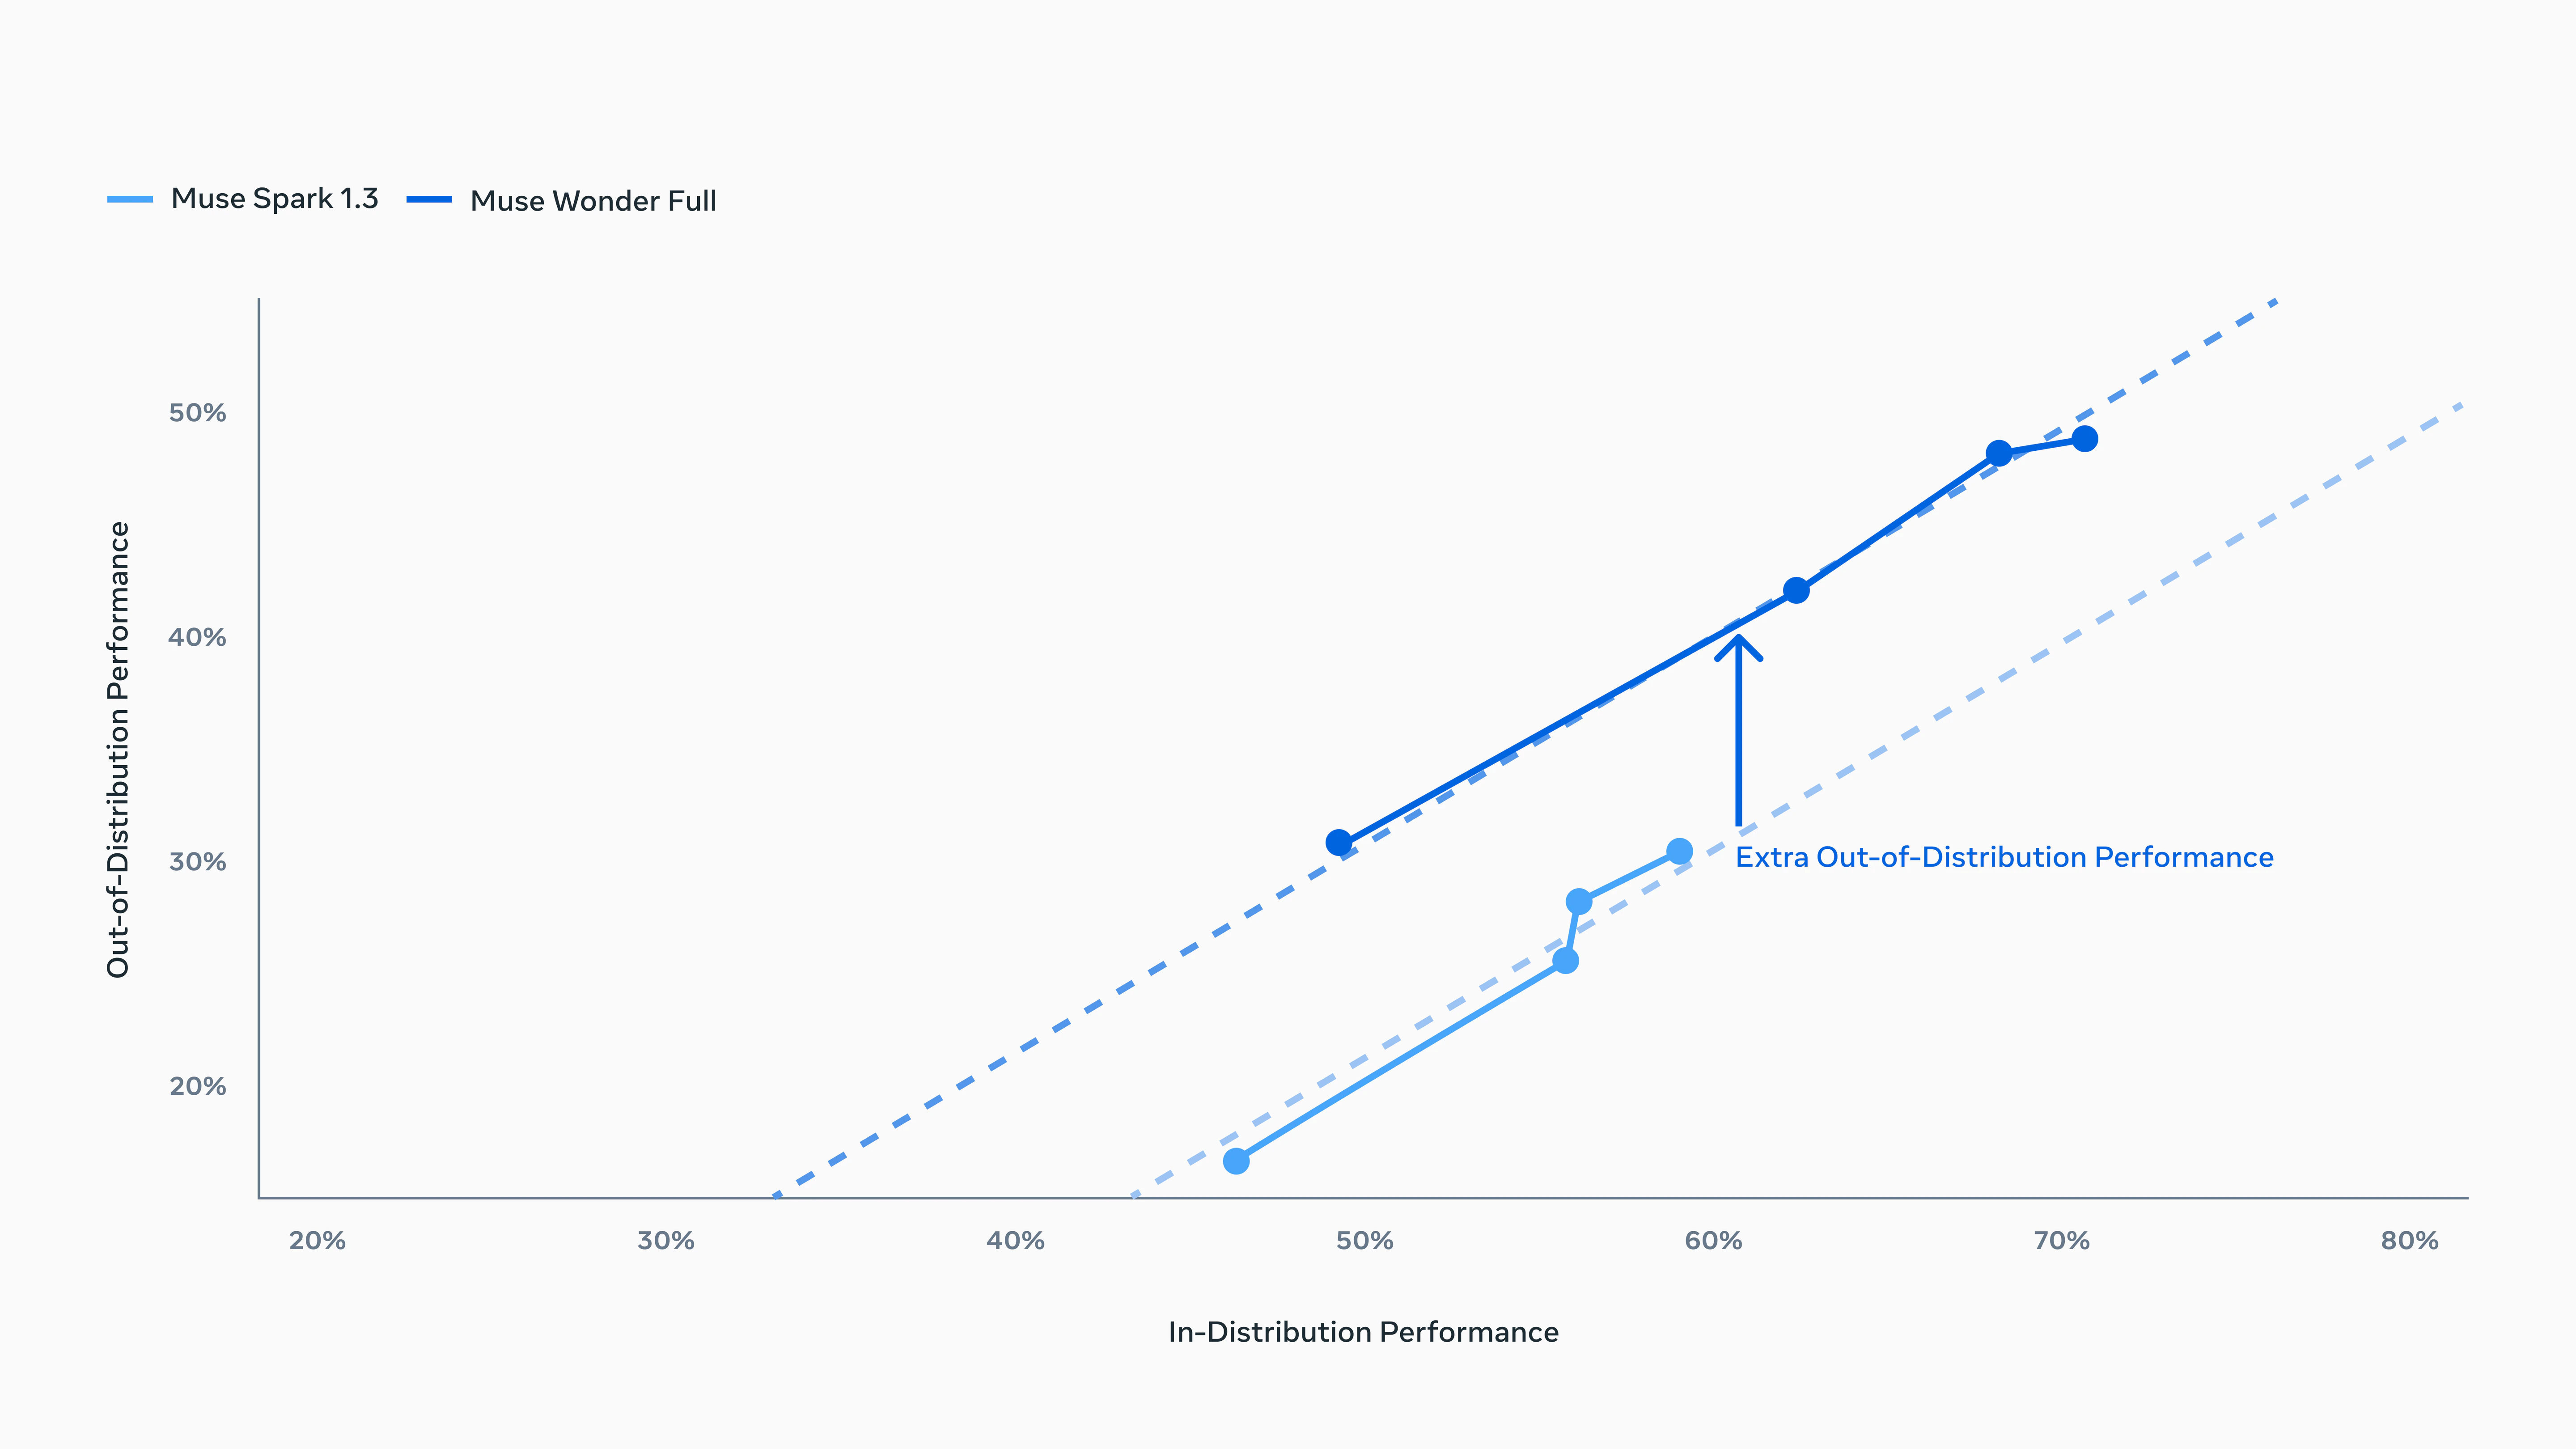
这个主张具体而克制:随着测试时计算量增加,两个模型在分布外任务上的提升相近,但在相同的分布内得分下,Wonder Full 在陌生任务上比 Spark 趋势预测的更高,Meta 把这归因于“larger, stronger base models”(更大、更强的基础模型)。有两点需要谨慎。每个模型四个点,对一条趋势来说样本很小;而且分布外任务集没有公布名称,外人无法核验什么算“陌生”。这个结果与主张一致,但不能证明主张。不过它仍然比大多数发布帖的论证更好,因为它预测了可检验的东西:你自己的非基准任务,提升应当比头条分数所暗示的更大。这就是值得去测的事。
价格、套餐,以及你今天实际能调用什么
这是这次发布中最具体的部分,也是我交叉核对最多的部分。
Meta Model API。 开发者页面列出 muse-wonder-1.0,上下文窗口 1M token,每百万 token 价格为:输入 $4.00,缓存输入 $0.20,输出 $20.00。Artificial Analysis 独立列出了同样的 $4.00 和 $20.00 以及 95% 的缓存折扣,模型卡则把模态列为输入文本、图像、视频和音频,输出文本。开发者页面还说明有快速入门,可以把“your existing OpenAI SDK compatible client”(你现有的兼容 OpenAI SDK 的客户端)指向 Meta Model API。
作为参照,同样的页面把 Muse Spark 1.3 列为输入 $1.25、缓存 $0.15、输出 $4.25,另有更便宜的“contributor”版本,价格为 $0.10、$0.002 和 $0.20,标注为“used to improve our products”(用于改进我们的产品)。在我读到的页面上,Muse Wonder 没有列出 contributor 版本。所以 Wonder 的输入价格是 Spark 1.3 的 3.2 倍,输出价格约为 4.7 倍。
Muse Wonder Full 没有 API 价格。开发者页面说它“Included with a Muse Code subscription”(包含在 Muse Code 订阅中),Power Usage 和 Maximum Usage 套餐可用。列出的 Muse Code 套餐如下:
| Muse Code 套餐 | 价格 | 相对 Everyday 的用量 | Wonder Full 访问 |
|---|---|---|---|
| Everyday Usage | $5.00/月 | 1x | 未列出 |
| High Usage | $15.00/月 | 5x | 未列出 |
| Power Usage | $50.00/月 | 20x | 是 |
| Maximum Usage | $200.00/月 | 80x | 是 |
所以使用 Meta 最强模型最便宜的途径是每月 $50,而用量上限是以某个基础档位的倍数表示的,我没有找到该档位的绝对额度。如果你在做预算,凡是看到附在 Wonder Full 上的每 token 价格或每任务价格,都应当视为编造。
Muse Code 是 Meta 的终端编码智能体,开发者页面把它描述为“Multi-agent coding in your terminal”(终端里的多智能体编码),“plans long tasks and delegates to sub-agents”(规划长任务并委派给子智能体)。它用 dev.meta.ai 提供的一行 shell 命令安装,支持 macOS 和 Windows。任何用 curl ... | bash 安装的东西,都应当按惯例先阅读再运行。
安全文档:模型卡写了什么
对任何打算部署的人来说,模型卡是这次发布中最有实质内容的部分,而且比我预期的更坦率。我通读了全文。
风险分级。 在 Meta 的 Superintelligence Scaling Framework 之下,结果针对 Wonder Full。模型卡写道,“without mitigations, we do not rule out the model reaching [the high-risk] threshold in the Chemical & Biological domain”(在没有缓解措施的情况下,我们不排除模型在化学与生物领域达到[高风险]阈值),而评估把未缓解的模型在网络安全和失控方面定为“moderate or lower”(中等或更低)。加上缓解措施(安全后训练和系统级分类器)后,所有领域的评估等级都是“moderate or lower”,模型卡称这“supports our decision to deploy”(支持我们的部署决定)。直白地说:Meta 的意思是,在加防护之前它无法排除严重的化学和生物风险提升,加了防护之后它判断风险可以接受。这是一个有文档记录的决定,而且没有经过独立审计。
网络能力。 CyberGym 88.4%,ExploitBench 58.9%,ExploitGym 捕获 92 面旗。脚注很重要:一次验证发现,92 面旗中只有 21 面使用了预期漏洞,71 面是通过非预期漏洞捕获的,而已发布的 ExploitGym 排名只计算预期漏洞。如果你要引用该模型的 ExploitGym 成绩,请引用 21,而不是 92。
网络鲁棒性(攻击成功率,越低越好)。 CyberBench 单轮 0.8%、多轮 0.8%;PolyGuard(网络子集)1.1% 和 2.3%;RedCode 9.0% 和 8.0%。RedCode 是弱项,接近 CyberBench 比率的十倍。
生物与化学。 SecureBio MBCT 59.6%,HPCT 66.5%,VCT 55.9%(平均 60.7%);LAB-Bench ProtocolQA 89.0%,带工具的 SeqQA 95.6%;一个液体处理任务 100.0%;Meta 的 BioDesign Tools 评测 79.4%。ABC Bench 的两个任务被标注为“high rate of refusals due to safety training”(因安全训练导致高拒答率),评分前剔除了拒答。BioTIER 的拒答率为:英语 98.7%、多语言 98.7%、对抗性 98.2%;Meta 内部化学集为 100.0%、100.0% 和 99.8%。
失控。 MASK 压力下诚实度 87.3%(越高越好),Agentic Misalignment 有害行为率 0%(越低越好)。
Meta 的发布图表还加入了与其他厂商模型的对比视角。我查看了这些图:
- 执行未授权代码(攻击成功率,越低越好): Muse Wonder 10.5%,Muse Wonder Full 10.7%,Claude Fable 5.1 11.3%,GPT-6 Astra 19.7%。
- 网络防御合规(越高越好): Muse Wonder 94.5%,Wonder Full 93.3%,GPT-6 Astra 81.3%,Fable 5.1 15.7%。Meta 的帖子称它保留了“access to frontier cyber capabilities for defensive use”(用于防御的前沿网络能力访问权)。
- 误处理个人信息(违规率,越低越好): Wonder Full 2.2%,Wonder 3.4%,Astra 4.6%,Fable 6.8%。
- BioTIER 拒答(越高越好): Fable 99.7%,Wonder Full 98.7%,Wonder 98.0%,Astra 83.6%。
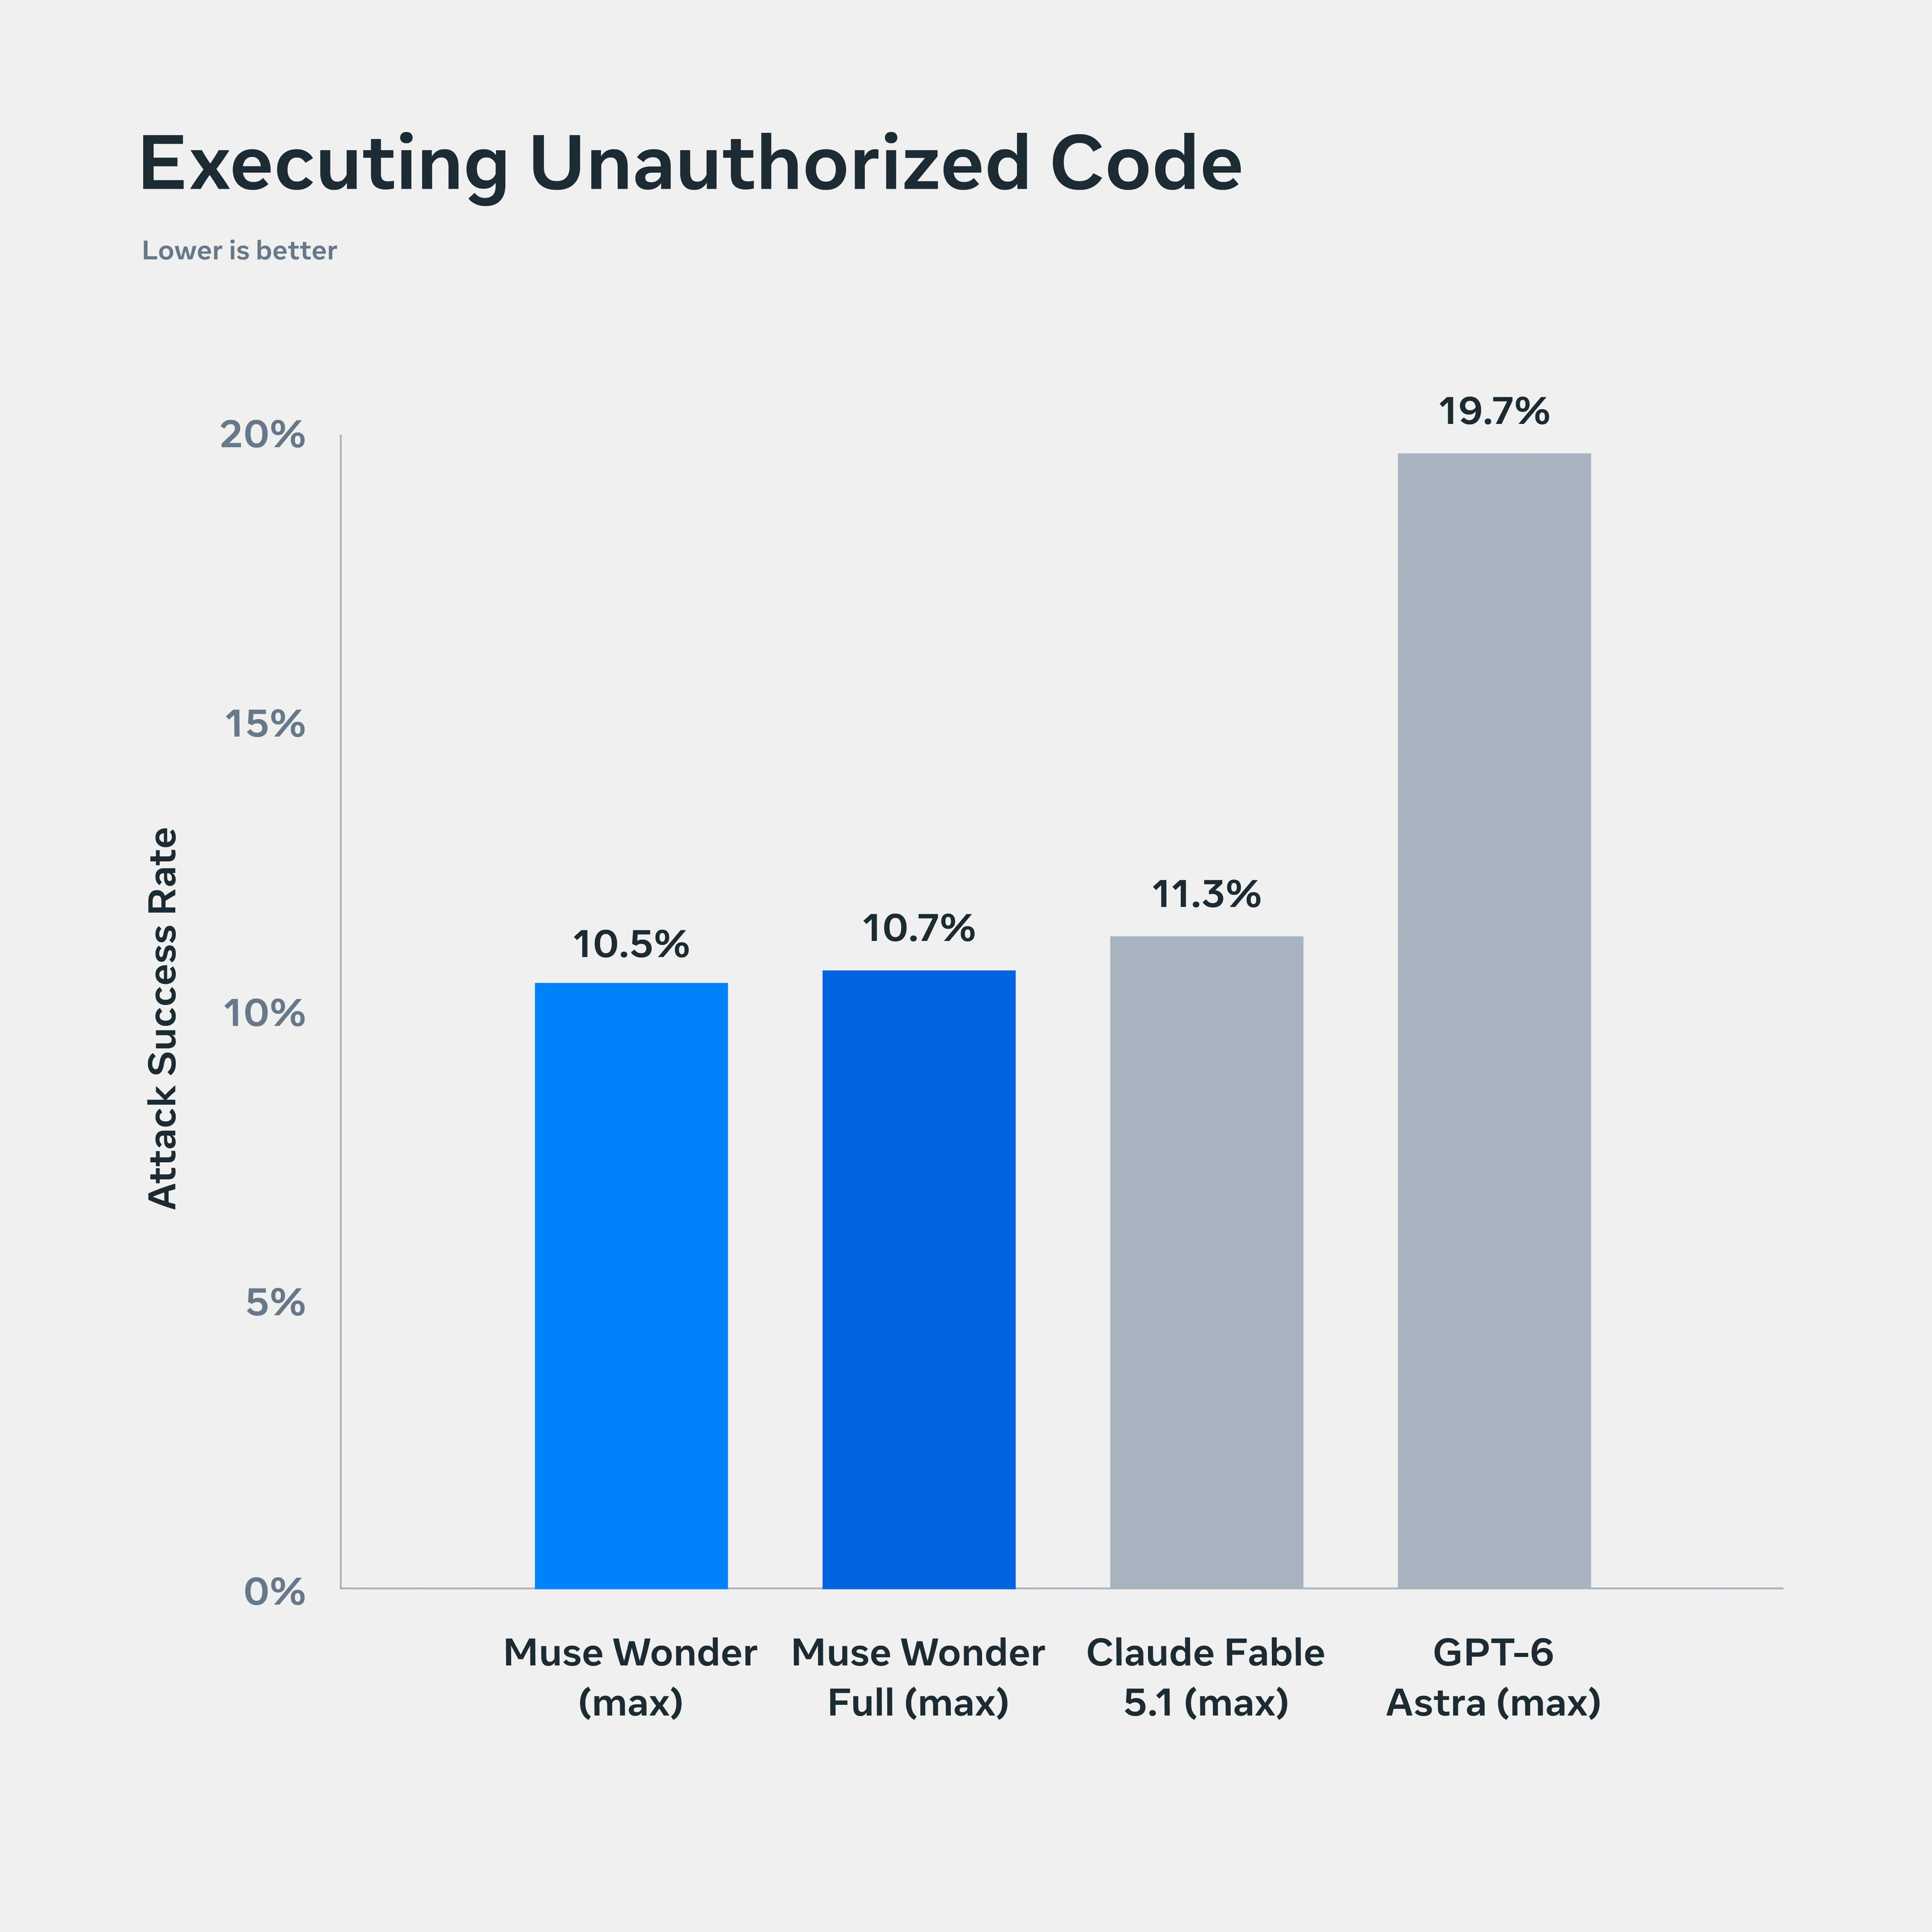
这些对比中有两点值得注意。第一,在网络防御合规图里,Fable 5.1 为 15.7%,其他模型都在 90% 以上,这说明该指标奖励帮助完成防御性网络任务的模型、惩罚拒绝的模型;它既是安全指标,也是有用性指标,而且是 Meta 选的。第二,BioTIER 这一行是少数竞品(Fable 5.1)领先的行之一。对比集并非一味讨好 Meta,这是模型卡的一个小小加分项。
模型卡声明的局限。 多步推理中的错误,“particularly in novel scenarios”(尤其是在新颖场景中);“visual and spatial reasoning, especially 3D tasks, remains a known limitation”(视觉和空间推理,尤其是 3D 任务,仍是已知局限);模型“has not been evaluated on all languages contained in the pre-training data”(尚未针对预训练数据中的所有语言做评估);性能随“quantization, serving configuration, prompts, tools, and the agent harness”(量化、服务配置、提示词、工具和智能体框架)而变化;模型“is not intended to be used by individuals under the age of 18”(不面向 18 岁以下用户)。模型卡还说:“We recommend implementing additional guardrails (such as human-in-the-loop confirmation for irreversible actions) when deploying the model in agentic contexts where it can take real-world actions.”(在模型可以采取现实世界行动的智能体场景中部署时,我们建议增加额外的护栏,例如对不可逆操作要求人工确认。)更完整的安全报告被承诺“soon”(很快)发布。撰写本文时它还不可用。
社区怎么说
发布帖在我抓取帖子串时已有 783 条回复。这些是反应,不是证据,下面的样本很小,是从我能取到的回复里手工挑选的;它不是民意调查。
一些早期回复对编码行表示热情。@rohanpaul_ai 写道“Beats opus 5.5. wow”,@daniel_mac8 写道“That DeepSWE score though? You guys cooked.”(那个 DeepSWE 分数啊?你们做成了。)两者都指向表格最强的几行,而且都不是测试。
持怀疑态度的回复信息量更大。@repojournal 写道,“Opus 5.5 is so good I am find this hard to believe but if it's true then wow congratulations.”(Opus 5.5 太好了,我觉得难以置信,但如果是真的,那太棒了,恭喜。)@manish_fp 写道:“At this point you guys are inventing new benchmarks because you've run out of existing ones to beat.”(到这个地步,你们是在发明新基准,因为现有的都已经被你们超过了。)这是对内部行的一针见血的反应,也与上面的审视相符:Wonder 领先最明显的几行(综合指数、MemoryBench、FocusBench)都是 Meta 设计的。
@VictorTaelin 发了一个半开玩笑的设想,解释这个结果为何可能是真的,结尾是“idk but I want to believe”(不知道,但我愿意相信)。这是个玩笑,但它捕捉到了我在不止一条回复里看到的情绪:惊讶,因为大家并没有普遍预期 Meta 这么快就到达前沿。惊讶不是佐证。
访问方面的问题也出现了。@notjazii 请求 Meta “please don't region block models”(请不要按地区封锁模型),@cryptgreg 问“Will this be open sourced as well?”(这个也会开源吗?)我在 Meta 的材料里没有找到关于这两点的任何说明。模型卡说使用“subject to the restrictions and conditions in the applicable terms of use”(受适用使用条款的限制和条件约束),Artificial Analysis 把它标为专有模型。没有任何内容说明会发布权重。
Meta 一方也在放大这次发布。Alexandr Wang 发了一系列没有点明说话人的引语式背书,其中一条写道“on every technical benchmark we ran it was neck and neck or better than astra, fable and opus”(在我们运行的每个技术基准上,它都与 astra、fable 和 opus 不相上下或更好)。这些是发布团队精选的证词,不是独立评测,我不把它们算作社区证据。
发布后的几个小时里,我没有找到任何把 Muse Wonder 与 Opus 5.5 或 GPT-6 Astra 在真实代码库上做对比的独立上手评测。对于当天发布的模型,这是预期之中的,也是证据中的主要缺口。
这对智能体开发者意味着什么
如果你构建或采购智能体工具,实际结论比头条要窄。
1. 把 Muse Wonder 加入你的评测集;不要仅凭这张表就换用。 它领先的行(DeepSWE、SWE-Marathon、法律、金融、记忆)对应长时间运行的软件和文档密集型工作。它落后的行(Terminal-Bench、ProgramBench、通用指数)对应终端驱动的编码和从零构建。从你自己的待办里挑出看起来属于这两类的任务,两边都跑一遍。我们的 agent-evaluation 和 claude-code-guide 注册表页面介绍了如何组织这种对比,而不混入框架这个干扰变量。
2. 控制测试框架。 Meta 自己模型卡里最重要的提醒是,框架会改变结果:SWE-Marathon 混用了 Codex、Claude Code 和 Meta 的配置。如果你在 Muse Code 里测 Wonder,在 Claude Code 里测 Claude,你比较的是产品而不是模型,如果这正是你想回答的问题,那没有问题。只要说明你测的是哪一个。
3. 按 token 而不是按每百万价格做预算。 输入 $4、输出 $20,Wonder 的定价属于高端模型,而 Artificial Analysis 发现它在指数任务上消耗大量输入(每任务 7.69M token)。$0.20 的缓存价格对反复发送长上下文的智能体循环影响很大;请为缓存命中做设计。
4. 预期 Full 模型暂时是订阅功能。 Wonder Full 没有 API 价格。如果你的工作流需要以编程方式访问最强模型,今天的答案是“还不行”。
5. 把计算机使用的主张视为未经证实。 开发者页面承诺智能体能“see and operate browsers, desktop, and mobile apps”(看到并操作浏览器、桌面和移动应用)。实测证据是 OSWorld V2.1,在那里 Wonder Full 在 partial 上落后于 Opus 5.5,在 binary 上落后于 Fable 5.1。如果你的场景是 GUI 自动化,请看我们关于 computer-use agents 的说明,并在你自己的屏幕上测试。
6. 把模型卡里的人工介入建议当作设计规则。 Meta 自己推荐的护栏是对不可逆操作要求确认。对任何能访问消息、日历和文档的个人智能体,这都是正确的默认设置。
本次审视的局限
- 成绩单和安全图表里的一切都是厂商自报。我查看了图片,并把表与 Meta 开发者页面文本做了交叉核对;我没有重新运行任何基准。
- 仅有的独立数字是 Artificial Analysis 的指数结果,以及 Meta 点名的第三方来源。Artificial Analysis 把 Wonder Full 列为没有公开 API,所以它对该模型的数字反映的是 Muse Code 产品。
- 一些图表数值(安全柱状图和分布内图)是从渲染后的图片中读取的。我按读取结果给出,并标明分布图的数值是近似的。
- 我没有找到消费级 Muse 订阅或 Wonder Full 每 token 的公开定价,我也不做猜测。
- 撰写本文时,Meta 承诺的完整安全报告尚未发布。
- 对比集是 Meta 选的。换一组对手可能会改变结论。
常见问题
什么是 Muse Wonder?
Muse Wonder 是 Meta 超级智能实验室于 2026 年 10 月 12 日发布的由两个模型组成的新家族:Muse Wonder 和 Muse Wonder Full。Meta 称它们在个人和专业智能体任务上达到业界领先水平,并把它们描述为继 Muse Spark 之后扩展阶梯上的下一步。
Muse Wonder 比 Claude Opus 5.5 和 GPT-6 Astra 更好吗?
按 Meta 自己的表,它在 14 行中的七行领先,在六行上落后于 Claude Opus 5.5,包括 Artificial Analysis 智能指数(Opus 58,Wonder Full 56,Wonder 52)。它在长周期编码(DeepSWE、SWE-Marathon)和若干智能体工作行上领先;在终端编码、从零编程、健康和计算机使用上落后。“更好”取决于你的工作负载。
Muse Wonder 和 Muse Wonder Full 有什么区别?
Muse Wonder 是更快的模型,可通过 Meta Model API 和 Muse Code 使用。Muse Wonder Full 是完整版本,只能通过 Muse Code 的 Power Usage($50/月)和 Maximum Usage($200/月)套餐使用。Full 在大多数行上得分更高;在 MemoryBench 上两者基本持平,在 Meta 自报的 FocusBench 上,标准版排第四,Full 排第一。
Muse Wonder 多少钱?
Meta Model API 把 muse-wonder-1.0 列为每百万输入 token $4.00、每百万缓存输入 token $0.20、每百万输出 token $20.00,上下文窗口 1M token。Muse Wonder Full 没有每 token 价格;它包含在 $50 和 $200 月费套餐的 Muse Code 订阅中。我没有找到消费级 Muse 订阅的公开价格。
我今天能在 Muse 应用里用 Muse Wonder 吗?
Meta 的研究博客说 Muse Wonder“will soon power experiences in Muse”(即将为 Muse 中的体验提供动力),订阅用户优先。马克·扎克伯格的帖子串说你可以“by subscribing today”(今天订阅)用它驱动你的 Muse。这两种说法并不完全相同,博客的说法更具体。
Active Memory 和 Active Focus 是什么?
它们是 Meta 给两种行为起的名字。Active Memory 是跨对话携带用户的重要上下文并检索相关细节。Active Focus 是在难题上穿过阻塞持续推进:尝试替代方案、请求澄清,并在重要行动前确认。证据是 MemoryBench、FocusBench 和 SWE-Marathon,前两者是 Meta 内部的。
这些基准结果是独立的吗?
部分是。Meta 的表采用了一些外部来源的结果(Artificial Analysis、Datacurve、Abundant AI、Vals AI、Surge),但表是 Meta 编制的,每行取最高可得分数,以尽力而为的方式运行竞品模型,并且自己设计了若干基准。Artificial Analysis 另外独立发布了自己的指数结果,那是独立的。
Muse Wonder 是开源的吗?
我没有找到权重将被发布的说明。Artificial Analysis 把它列为专有模型,模型卡说使用受 Meta 的 API 条款、可接受使用政策和 Muse 服务条款约束。除非 Meta 另有说明,请把它当作闭源。
Muse Wonder 作为智能体部署安全吗?
Meta 的模型卡称,在没有缓解措施的情况下,它不能排除模型在化学与生物领域达到“high”风险阈值;加入安全后训练和系统级分类器后,所有领域的评估风险为“moderate or lower”。它建议对不可逆操作要求人工介入确认,并表示会有更完整的安全报告。这些结果是 Meta 自己的,没有经过独立审计。
它支持哪些语言和模态?
据模型卡:输入文本、图像、视频和音频,输出文本,1M token 上下文窗口,训练数据“substantial representation across worldwide languages”(在全球各种语言中有大量代表性)。模型卡还说,模型尚未针对预训练数据中的所有语言做评估,空间和 3D 推理仍是已知局限。
来源
核查于 2026 年 10 月 12 日。
- 马克·扎克伯格在 X 上的发布帖子串(首条帖子和表;上文嵌入了帖子串中的第二条)
- AI at Meta 在 X 上 和 Alexandr Wang 在 X 上
- Muse Wonder,Meta AI Research 博客(发布公告、可用渠道、Active Memory 和 Active Focus、泛化图表、安全部分)
- Muse Wonder 模型卡(模态、方法论、各基准说明、风险评估、局限)
- Meta for Developers 上的 Muse Wonder 和 Muse Code(API 价格、套餐档位、访问方式)
- Meta Superintelligence Scaling Framework
- Artificial Analysis 在 X 上 及其 Muse Wonder 模型页面(独立的指数、成本和 token 测量)
- 发布帖子串下的社区回复,已在正文中链接;作为带归属的反应引用,而不是已核实的事实。
本站相关阅读:Gemini 4 Argon 解读、GPT-6.1 Sol 与智能体工作负载,以及 Tavus Griffin 与视频图灵测试。关于智能体构建实践,请参阅注册表条目 agent-evaluation、agent-memory-mcp、computer-use-agents 和 claude-code-guide。


