Gemini 4 Argon:Google 新前沿模型全解析
Google DeepMind 的 Gemini 4 Argon:1M token 输出上限、厂商自报基准、Fairwind 访问路径、入门定价,以及开发者现在可以做的准备。
Agent Skills
Gemini 4 Argon:Google 新前沿模型究竟改变了什么
2026 年 9 月 30 日,Google DeepMind 发布了新前沿模型 Gemini 4 Argon,面向真实软件工程、法务与金融等企业知识工作、以及网络安全防御这类长时程任务。最具体的结构性变化是输出预算:Argon 把上限提升到1M 输出 token,此前的 Gemini 模型为 64K。访问先从 Fairwind Program 中一小批受信任的网络防御者开始;Google 表示面向开发者、企业和消费者的更广泛开放会「尽快」到来,最先覆盖付费 API 客户与 Google AI Ultra 订阅者。
现实的症结在于:截至本文发布时,Argon 在 Gemini API 中没有公开的模型标识、没有定价行、也没有模型卡。本文会把这条界线说清楚——哪些是 Google 已经声明的、它自己的材料究竟展示了什么、以及哪些东西尚未上线。
Google 公布了什么
Google 自己对这次发布的表述简短而具体。Argon 被称为公司「下一个前沿智能时代」,训练目标是跨越复杂长时程工作流维持深度推理,并被定位在三个明确的领域:软件工程、企业知识工作(法务、金融)以及网络安全防御。发布文章由 Google DeepMind 高级副总裁兼 Google 首席 AI 架构师 Koray Kavukcuoglu 署名。
两个转发这次公告的官方账号以不同详细程度讲了同一件事。Google DeepMind 把它描述为一款「今天开始向 Fairwind Program 中一批受信任测试者」开放的前沿模型。
@Google 账号补充了可用性表述——最初一批网络防御者——以及 1M token 这个数字。
Sundar Pichai 的帖子值得读的是框架而非功能清单,因为它是公司把「防护措施」而非仅「能力」作为分阶段开放理由的最清晰表述:
把这几条放在一起读,线程毫无歧义地确立四个事实:模型存在、名字是 Gemini 4 Argon、访问受限、输出上限为 1M token。其余内容——基准、定价、网络防御姿态——来自发布文章和 Fairwind 项目材料,而且都是 Google 关于 Google 自己的说法。

1M token 输出上限到底意味着什么
输出上限很容易与上下文窗口混淆,而两者的区别决定了这次发布是否与你有关。上下文窗口是模型一次能读到的全部内容——提示、文件、检索到的文档、历史轮次。输出上限则是模型在单条轨迹中能写出多少。Argon 的上下文窗口并未在发布材料中说明;发生变化的是输出侧的那个数字。
Google 的说法是,从 64K 提升到 1M 输出 token 让模型「有空间深度思考并在单条轨迹中生成数十万个 token」。实际含义是:一次运行可以产出整套大型补丁、一份长迁移计划,或一份完整分析文档,而不会在中途被截断。
有三件事它并不意味,而每一件都是常见误读:
- 它不是免费的上下文。 1M token 输出并不代表 1M token 输入窗口。两种容量彼此独立,而发布文章只主张了输出数字。
- 它不会自动更快。 更长的单条轨迹减少了往返次数,但生成一百万个 token 仍要付出相应的时间与金钱。价值在连续性,不在速度。
- 它不保证长任务的正确性。 长度是预算,不是证据。一份 700K token 的补丁能否干净地应用,正是下面那些基准试图近似、而你自己仓库会给出不同答案的问题。
对这项变化的诚实解读是:Argon 移除了一个曾迫使长时程智能体任务拆成多次交接的硬上限,而每次交接都有丢失上下文的风险。它对你是否有意义,取决于你的智能体现在多久会撞上输出上限。如果从不撞上,这就是本次发布里最不重要的一点。
基准快照
本节所有数字均为厂商自报。评估由 Google 运行或委托,分数由 Google 公布,且大多数未公布完整测试框架配置。据我们对本文所核查官方来源的了解,截至 2026 年 9 月 30 日,不存在任何针对 Gemini 4 Argon 的独立第三方复现。
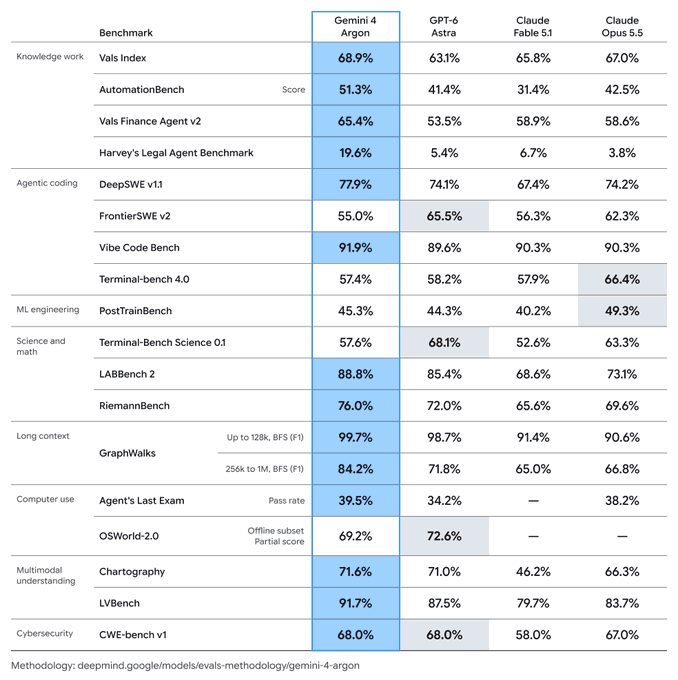
发布文章的比较表把 Argon 与 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 并列。转录如下:
| 类别 | 基准 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 知识工作 | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| 知识工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 知识工作 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 智能体编程 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 智能体编程 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 智能体编程 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 智能体编程 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 机器学习工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学与数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科学与数学 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科学与数学 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 长上下文 | GraphWalks(最高 128k,BFS F1) | 99.7% | 98.7% | 91.4% | 90.6% |
| 长上下文 | GraphWalks(256k 至 1M,BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| 计算机操作 | Agent's Last Exam(通过率) | 39.5% | 34.2% | — | 38.2% |
| 计算机操作 | OSWorld-2.0(离线集,部分得分) | 69.2% | 72.6% | — | — |
| 多模态理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 多模态理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 网络安全 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
已公布表格上的方法论引用:deepmind.google/models/evals-methodology/gemini-4-argon。
规律并不是「Argon 全胜」,而这样读这张表才更有用。Argon 在每一行知识工作、两行长上下文以及两行多模态上都领先。它在长时程软件工程基准 DeepSWE v1.1 上创下 77.9% 的新高。但 GPT-6 Astra 拿下 FrontierSWE v2(65.5% 对 55.0%),Terminal-bench 4.0 属于 Claude Opus 5.5(66.4%),Terminal-Bench Science 0.1 归 GPT-6 Astra(68.1%),OSWorld-2.0 离线集也是 Astra 的(72.6% 对 69.2%)。
有两行值得细看,因为它们最容易被断章引用。
Harvey's Legal Agent Benchmark 显示了表中最宽的差距——Argon 19.6% 对 Opus 5.5 的 3.8%——同时也是最低的绝对分数。一个最强模型大约只能答对五分之一的基准,衡量的是难题,而不是已解决的问题。差距真实且为厂商自报;绝对水平则提醒我们法律智能体工作仍处早期。
Terminal-Bench Science 0.1 是科学类中 Argon 落败的那一行,且差距明显:57.6% 对 GPT-6 Astra 的 68.1%。如果你只读到「前沿模型在知识工作上领先」这个标题,就会错过同一批材料显示它在科学工作流上落后。发布文章没有解释这一差异,也没有给出配置对比。
这些数字都不应被当作产品定论。它们是单一厂商在其自行选定的基准上、对自行选定的竞品、在基本未公布的配置下取得的结果。
网络防御:这批材料中最扎实的证据
网络防御是 Google 公布材料最细的部分,包括三张图表。它们仍是厂商自报,但图表足够具体,可以批判性地阅读,其中两张还把 Argon 直接与 Google 上一代网络模型 Gemini 3.8 Flash Cyber 对比。
在评估模型修复安全漏洞能力的 CWE-bench v1 上,公布的排行榜显示三方并列第一:
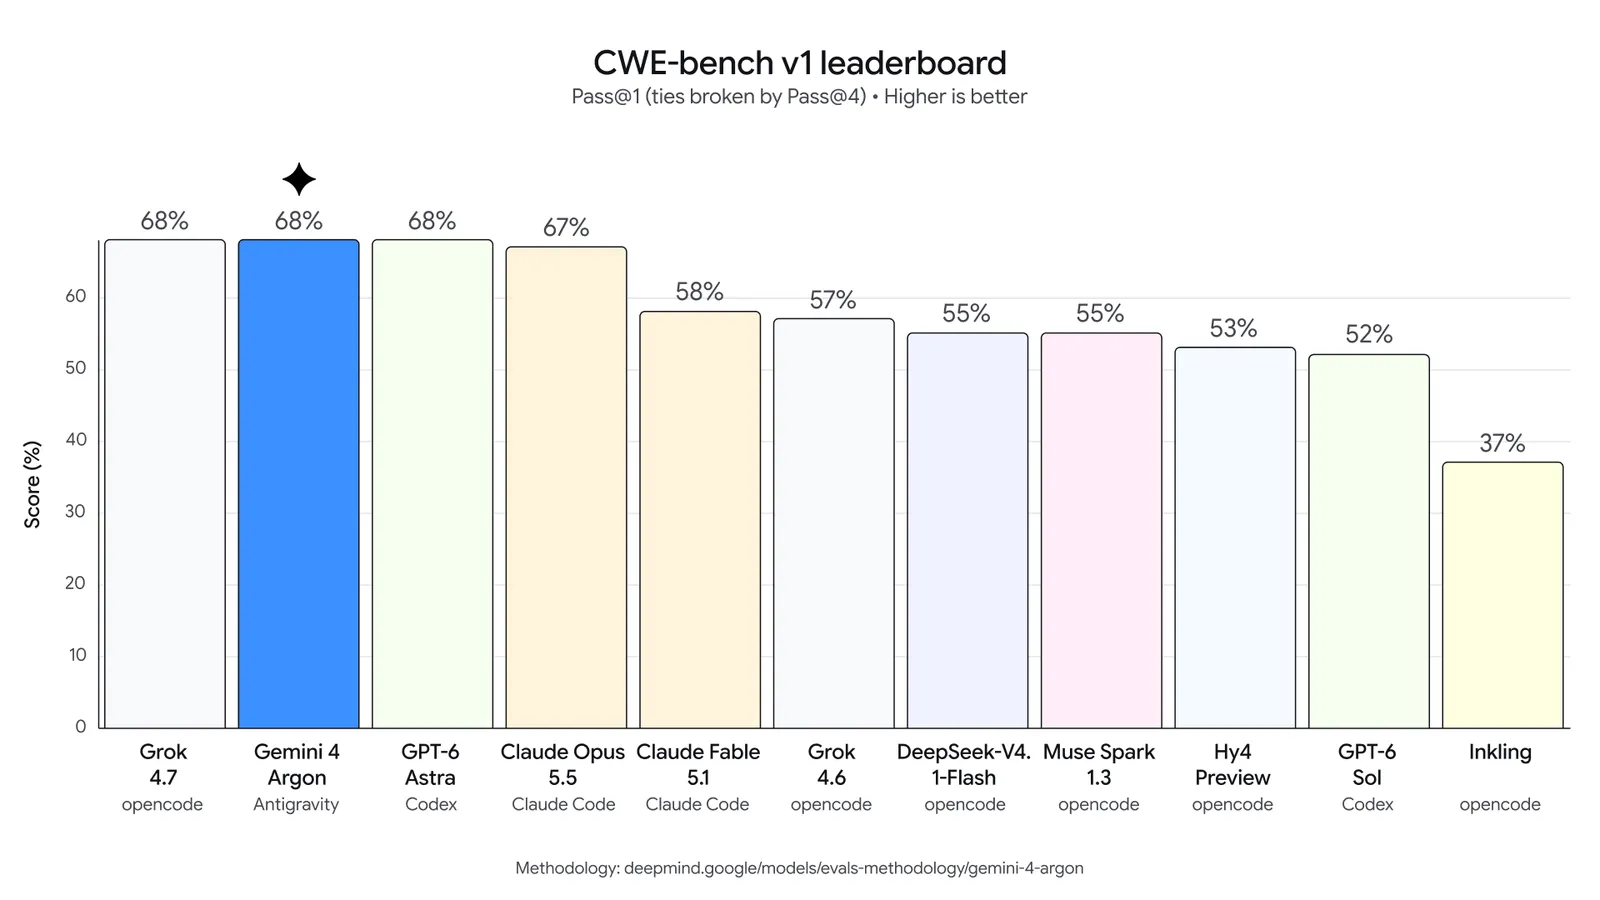
发布文章称 Argon「以 68% 的最高分并列第一」,图表印证了这一点。注意这个并列:三个模型落在同一数字上,所以这里的「第一」是「并列第一」,而不是「领先全场」。
在衡量抵御被夹带进上下文的恶意指令能力的 **Gray Swan 间接提示注入(IPI)**基准上,越低越好。Google 的图表把 Argon 放在全场最低:
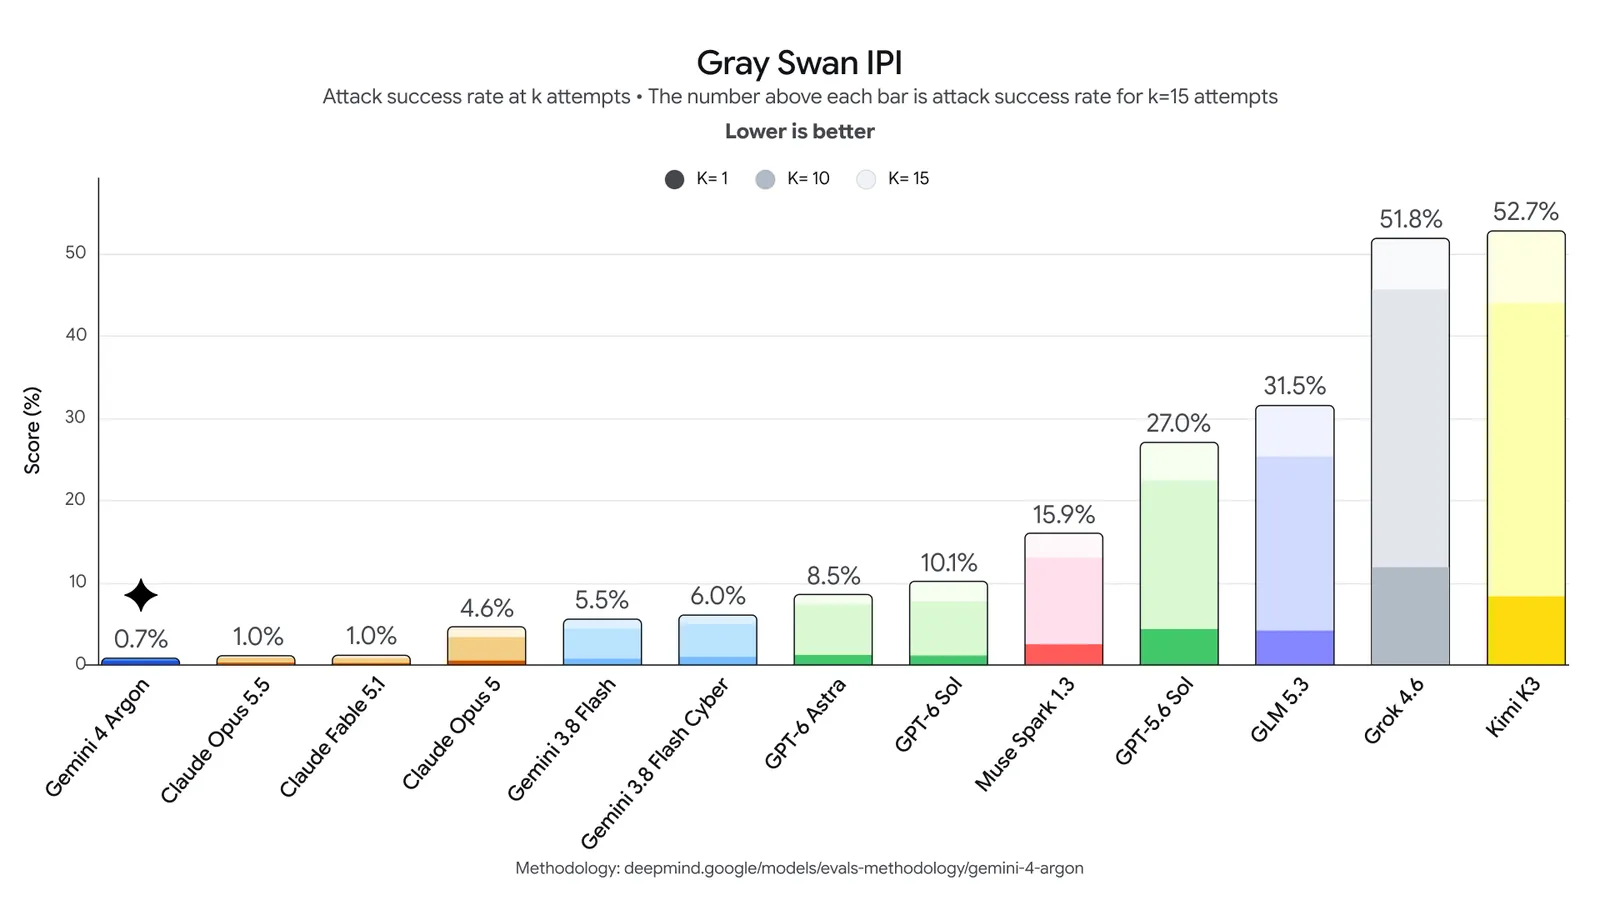
15 次尝试下 0.7% 的攻击成功率,对于任何在构建智能体测试框架的人来说都是本次发布中最有意思的数字,因为提示注入正是智能体技能从所读工具与文档中继承来的失败模式。
第三张图覆盖漏洞发现,含两个面板——Google 跨复杂代码库的内部基准,以及 Wiz 的黑盒渗透测试基准:
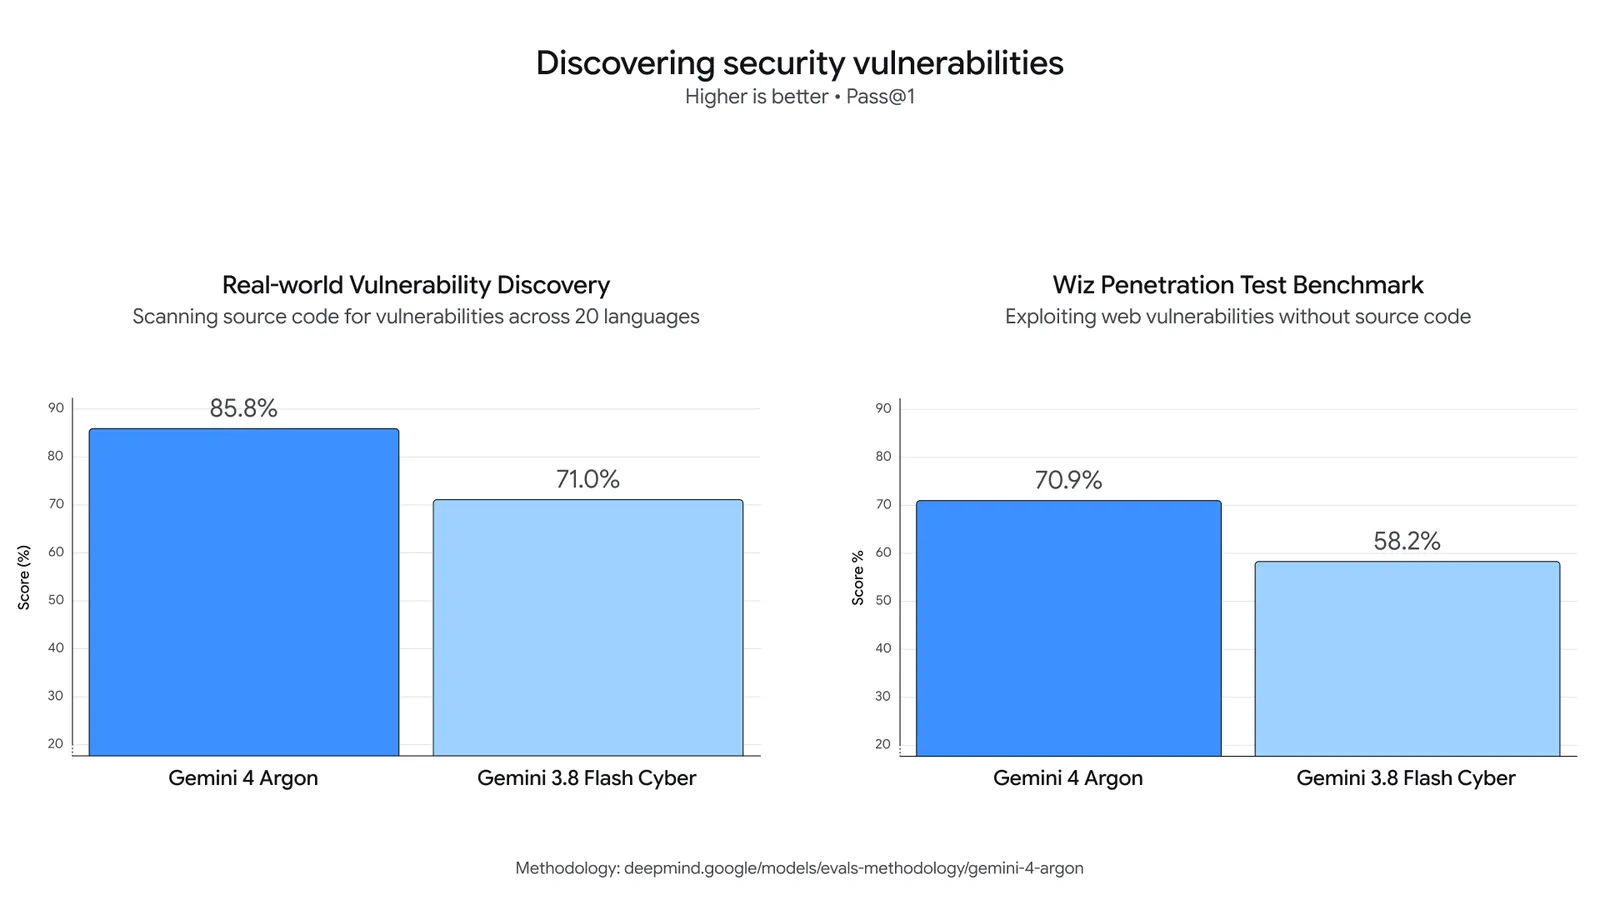
两个面板都显示相对 3.8 Flash Cyber 一致的方向性跃升。Wiz 面板在图上标注为「Wiz Penetration Test Benchmark」;发布文章把它描述为 Wiz 的内部黑盒基准。两个面板的实际前提说明相同:这些是内部或合作方基准,而不是你可以重跑的公开评估。
发布文章还提出了一条无法从材料中核实的真实世界影响主张。它称 Wiz 通过其 Scan for Good 计划使用 Argon,在全球医院使用的医疗软件中发现了一个早期前沿模型漏掉的关键漏洞。这是一条强主张,仅凭 Google 与 Wiz 自己的叙述;没有引用任何公告、CVE 或复现,因此应作为厂商叙述来读,而非已确立的事实。
对防御者而言有一个关键的运维细节:Google 表示会向受信任的防御者及其内部团队在无网络防护栏的情况下发布 Argon,正是为了让他们用上完整的前沿级网络防御能力。这是一个深思熟虑的双用途取舍,也是访问被置于 Fairwind Program 之后、而非自助注册的原因。
Fairwind Program 是什么
Fairwind 是访问闸门,且在 Argon 之前就已存在。Google 于 2026 年 9 月 2 日启动该项目,作为面向政府与受信任合作方的受限访问安排,把 Gemini 3.8 Flash Cyber 与代码安全智能体 CodeMender 结合。Argon 是首个通过它发布的前沿模型。
项目公布的条款最值得一读,因为它们界定了谁能接触模型:
| 维度 | 公布规则 |
|---|---|
| 谁可获得 | 政府与国家网络主管机构、关键基础设施运营者(医疗、电信、能源、金融)以及核心技术平台;从事防御性基准测试的学术实验室可申请 |
| 允许的工作范围 | 仅限双用途任务:经授权的威胁模拟、逆向工程,以及用于防御与学术研究的恶意软件分析 |
| 访问治理 | 用户级身份验证、抗钓鱼 MFA、访问控制;访问仅限内部网络安全、事件响应或渗透测试团队 |
| 再分发 | 合作方不得共享、再分发或转售对前沿模型的访问 |
| 审查 | 对申请机构做背景审查,核实安全历史与合乎伦理的运营记录 |
| 数据处理 | 作为 Gemini Enterprise Agent Platform 上的托管模型访问时,支持零数据留存 |
Google 称该项目目前与超过 650 家合作方合作。该数字描述的是项目整体,而非 Argon 专属,也不代表目前有多少机构已用上 Argon。
对大多数开发者而言,这一节回答了一个简单问题:你无法从 Fairwind 拿到 Argon。 如果你的工作是政府、医院网络、电信或平台厂商的防御安全,项目申请页就是入口。如果不是,今天接触 Google 网络工具的可行路径是用 CodeMender 搭配通用可用模型,而非 Argon。
Google 内部:三个自用案例
发布文章中最具体的证据是关于 Google 自己如何使用 Argon,且全部为自报。文中给出三个例子,每个都带数字。
量子算法优化。 Google 称 Argon 帮助其量子计算研究者优化了拖慢重要应用的子程序的时空资源——量子比特 × 门。其中一个例子里,它在几分钟内超过了已发表的基线 40%。没有附加论文、仓库或问题说明,因此这是一条方向性主张,不是可复现的结果。
集群内存效率。 由 Argon 组成的智能体团队分析了全集群剖析遥测,并在 Google 数据中心自主识别并应用内存优化,铺开后释放了超过 300 TiB 内存,总节省估计为 500 TiB 至 1 PiB。已核实数字与估计数字在文中分开给出,这也是正确的读法:300 TiB 是 Google 说已落地的部分,500 TiB–1 PiB 是预测。
大规模 C/C++ 到 Rust 迁移。 这是最详细的例子。Google 描述 Argon 智能体在全公司把 C/C++ 代码库迁移到 Rust,规模从 re2、libgav1 等核心库的几万行一直到 Fuchsia OS Zircon 内核的 800K 行以上。对 libgav1(Google 的开源视频解码器),智能体接管了一个已有的 Rust 移植版,通过多轮剖析引导实验并研读编译器输出,替换了 32K 行 SIMD 代码,产出让编译器自动向量化的安全 Rust。Google 称结果是一个内存安全的解码器,比此前的 Rust 移植版快 2.7 倍,视频输出完全一致,并更接近优化后的 C++。
Zircon 这个细节附带一个重要限定,文章也明说:由于许多系统至关重要,这些大规模重写在上线前要经过严格的自动化与人工审计、仿真测试和评审。这是对如此规模智能体代码迁移的诚实表述——智能体产出 diff,人与工具链仍然负责合并。
广泛开放前的防护措施
Google 用一整节讲述它称在更广泛开放前必须加强的四个防护领域。这些是承诺与流程描述,不是基准结果。
- 防滥用。 依据 Google 的前沿安全框架,Argon 被设计为拒绝有害的网络与 CBRN 请求,同时保留合法的双用途研究。Google 称改进了监控模型内部激活以发现滥用的技术,且防护措施经内外部红队用人工与自动化攻击方式做了鲁棒性测试。
- 提示注入。 Google 称 Argon 是其迄今抵御间接提示注入最强的模型,并以上面那条 Gray Swan IPI 结果作为证据。
- 失准监控。 Google 称正在部署监控 Argon 思维链与动作的缓解措施,必要时停止执行;并有一套类似系统监控训练运行、向专职事件响应团队告警。它明确指出会小心不把发现反馈进训练,以免塑造出规避监控的推理方式。
- 系统加固。 Google 称在高风险训练或评估开始前隔离并封闭沙箱环境,与其智能体控制路线图相关,并打算与合作方分享这些实践。
还有一条对时间点很重要的治理表述:Google 称在逐步扩大访问的同时,正参与美国政府的前沿模型预发布自愿流程。这是发布分阶段且无日期的一个具体原因。
思维链监控这一点对智能体开发者有一个不那么直观的提示。Google 声明的设计目标是让推理足够透明,以便诊断失准;一个隐藏或丢弃模型推理的测试框架会破坏这一点,而 Google 鼓励业界在能力提升时保留推理透明度。如果你在构建智能体技能,这就是一个支持记录推理轨迹、而非把它们当作一次性产物的理由。
可用性、定价与缺失的部分
Argon 的发布顺序明确但无日期:先受信任测试者与网络防御者,然后开发者、企业和消费者「尽快」到来,最先覆盖付费 API 客户与 Google AI Ultra 订阅者。任何一步都没有给出日期。
定价以入门价给出,并说明了到期后的变化行为:
| 入门价 | 入门期之后 | |
|---|---|---|
| 输入 | 每 1M token 2 美元 | 每 1M token 4 美元 |
| 输出 | 每 1M token 10 美元 | 每 1M token 20 美元 |
| 缓存输入 | 输入 token 价格的 95% off | (同样折扣,作用于更高的基准价) |
把这些数字与当前的 Flash 代际并列,有两处很突出。第一,2 美元每 1M token 的入门输入价高于 Gemini 3.8 Flash 当前的 0.75 美元每 1M 输入,这本就是前沿层高于主力层的预期。第二,入门期后从 2/10 美元翻倍到 4/20 美元,才是应该据以规划的数字,因为预算的寿命比促销更长。
缺失的东西与已有的东西同样重要:
- 没有公开模型标识。 Gemini API 的模型页列出当前 Gemini 3.x 阵容,不含 Argon。开发者今天没有
gemini-4-argon端点可调用。 - API 层面没有定价行。 官方定价页只有 3.8 系列;Argon 的费率仅出现在发布文章中。
- 没有模型卡。 DeepMind 模型卡索引列出了每一款已发布的 Gemini 与 Gemma 模型,其中没有 Gemini 4 Argon 条目。这很重要,因为模型卡通常是安全评估、CCL 评估与已知局限所在之处。
- 没有演示视频。 我们核查了本文的官方来源,没有找到可嵌入的官方 Argon 演示视频。如果之后发布,应补进这一节。
已确认、可推断与未知
这次发布很容易被过度解读,所以按证据层级给主张分类会更有帮助。
| 条目 | 状态 | 依据 |
|---|---|---|
| Gemini 4 Argon 存在并已公布 | 已确认 | 官方发布文章与三个官方 X 账号 |
| 1M token 输出上限,此前为 64K | 作为已声明能力确认 | 官方发布文章与 X;API 文档中尚不可见 |
| 先通过 Fairwind 向网络防御者开放 | 已确认 | 官方发布文章与 X |
| 入门价 2/10 美元、缓存输入 95% 折扣 | 作为已声明价格确认 | 官方发布文章;无 API 定价行 |
| 基准分数(DeepSWE v1.1 77.9%、CWE-bench v1 68%、LVBench 91.7% 等) | 厂商自报 | Google 自己的图表与文字;未发现独立复现 |
| 内部案例(40%、300 TiB、2.7 倍、80 万行以上) | 厂商自报、内部数据 | Google 自己的叙述;未公布方法论 |
| 向受信任防御者发布无网络防护栏版本 | 作为已声明政策确认 | 官方发布文章 |
| 公开 API 可用性、模型标识、速率限制 | 未知/尚未公布 | 在 Gemini API 模型页与定价页中缺失 |
| 模型卡、安全评估、CCL 评估 | 尚未公布 | 在 DeepMind 模型卡索引中缺失 |
| 独立第三方基准结果 | 未发现 | 所核查官方来源中不存在此类来源 |
最有用的姿态是把能力主张当作一个强有力的假设,把可用性事实当作起作用的约束。你今天无法在 Argon 上构建;你可以决定是否朝着它构建。
对智能体技能开发者意味着什么
这次发布没有改变技能是什么——一个含 SKILL.md 文件、由智能体在任务匹配时加载的文件夹。它改变的是这些技能能合理瞄准的任务上限,以及它们所运行模型的风险画像。
三条影响直接来自证据。
长时程技能获得更多空间,但要等可用性落地。 1M token 输出上限是与智能体技能最相关的功能,因为驱动代码迁移、大规模重构或多文件生成的技能,恰恰是那些会撞上输出上限的技能。在 Argon 可调用之前,务实的做法是把技能设计成模型无关:把模型标识放进配置而非硬编码,并让工作流的上下文组装保持稳定。如果你今天针对 Gemini API 构建,gemini-api 覆盖了该 API 表面,而更广的 coding-agent 模式正是长时程工作所需的委派与复核形态。
提示注入鲁棒性是应据以设计的那个主张。 15 次尝试下 0.7% 的攻击成功率,如果站得住,对任何读取不可信输入的智能体都是显著改善。但技能不应假设它成立。防御模式——把检索到的文档与工具输出视为不可信——在注册表中收录于 indirect-prompt-injection,与之配套的技能供应链姿态则横跨安全类目。
网络安全的定位抬高了技能可触碰内容的利害。 Argon 的头号用例是自主发现并修补漏洞,而 Google 在无网络防护栏的情况下向防御者发布它。这是一条强大的工作流,也是一片严重的爆炸半径。生成补丁的技能应让改动经过复核:code-review 是合并闸门,而 cybersec-helper 与 secure-coding-cybersecurity 中的防御工具是「发现」的那一半。
还有一个定价表让其具体化的成本规划角度。长时程智能体循环的技能在其前缀稳定时收益最大,因为 95% 的缓存输入折扣只适用于被缓存的输入。ai-cost-optimizer 是把这个转成预算的注册表条目。关于这一层演进速度的更广背景,同代际的姊妹深度解析《Gemini 3.8 Live 与 Extended Thinking》覆盖了音频侧,而《面向编程智能体负载的 GPT-6.1 Sol》展示了 OpenAI 侧对应的成本取舍。
在 Argon 进入你的账号前可以运行的测试方案
你今天无法测试 Argon,但可以先把测试准备好,让它在进入你账号的那天给出答案而不是一个项目。下面这套方案设计为在你确实能访问的任意前沿模型上运行,并在 Argon 到来时原样重跑。
构建一组冻结的十个已完成任务的黄金集。 使用真实的已合并改动,而非合成提示,因为这里最重要的基准——长时程软件工程——恰恰是仓库特定上下文主导质量的那类工作。十个任务足以看出方向,也远不足以报告一个百分比。
每个任务记录四个数字,而不是一个。 是否成功、墙钟耗时、拆分为缓存输入/未缓存输入/输出的 token 用量,以及复核结果所花的人工分钟数。单次任务成本 = token 成本 + 按你自己费率折算的复核时间;一个每 token 更便宜、却产出你必须重写的 diff 的模型,在实践中反而更贵。
保持测试框架不变。 相同提示、相同工具集、相同仓库版本、每个模型相同的推理强度设置。一次改两件事,就学不到任何一件事。
确认缓存确实生效。 这是最常被跳过的一步,也是改变账单的一步。如果你的账单显示输入 token 按标准费率而非缓存费率计费,说明前缀在多次调用间发生了变化,折扣从未生效。对连续轮次的请求体做哈希;如果它变了,说明你的技能里有东西在重新生成前缀。
纳入你预期模型会失败的任务。 两三个真正困难的单次推理或科学任务应在集合中——正是 Google 自己在 Terminal-Bench Science 上路由给另一个模型的那种。只由便宜模型能解的任务构成的对比,经受不住与生产环境的接触。
在多次运行之间针对技能迭代,而不是针对模型。 智能体栈里有意思的变量通常是模型周围的提示与工具设计。固定模型,针对技能迭代直到成功率稳定,然后再换一次模型。这个顺序能把模型选择从你自己的结果中排除为混杂因素。
对一个已有的智能体技能安装来说,在 Argon 可调用之后,迁移应该很小:把技能的模型标识指向 Argon,保留一个更强的模型作为技能标记为高风险任务的升级目标,并重新建立 token 记账基线,让缓存与非缓存输入分开记录。如果某技能每轮都重写系统提示或工具列表,先修好它;没有哪个前沿模型能回报一个不稳定的前缀。
常见问题
Gemini 4 Argon 是什么? Google DeepMind 于 2026 年 9 月 30 日发布的一款新前沿模型,面向软件工程、企业知识工作与网络安全防御的长时程任务,输出上限为 1M token。
我今天能用 Gemini 4 Argon 吗? 不能通过公开 API。它先通过 Fairwind Program 向受信任测试者与网络防御者开放。Google 称更广泛的开放会「尽快」到来,最先覆盖付费 API 客户与 Google AI Ultra 订阅者,未给出日期。
1M token 输出上限是什么? Argon 可在单条轨迹中生成最多 1M 输出 token,此前 Gemini 模型为 64K。它是输出上限,不是上下文窗口大小,且发布材料没有说明 Argon 的上下文窗口。
Gemini 4 Argon 多少钱? Google 列出的入门价为每 1M 输入 token 2 美元、每 1M 输出 token 10 美元,缓存输入为输入价的 95% off。入门期之后,价格变为每 1M 输入 4 美元、每 1M 输出 20 美元。Gemini API 定价页上没有 Argon 的定价行。
这些基准经过独立验证了吗? 没有。本文每个分数都来自 Google 的发布文章或 Google 自己的图表。截至 2026 年 9 月 30 日,在所核查的官方来源中未发现任何针对 Gemini 4 Argon 的独立第三方复现。
Gemini 4 Argon 比 GPT-6 Astra 和 Claude Opus 5.5 更好吗? 取决于基准与配置。Argon 在 Google 的比较表上领先 DeepSWE v1.1、Vals Index、AutomationBench、LVBench 和长上下文 GraphWalks,并在 CWE-bench v1 上以 68% 并列第一。它在 FrontierSWE v2、Terminal-bench 4.0、Terminal-Bench Science 0.1 以及 OSWorld-2.0 离线集上落后。这张表的每一个维度都是厂商选定的。
Fairwind Program 是什么? Google 于 2026 年 9 月 2 日启动的受限访问项目,让政府与受信任合作方获得其先进网络防御能力——最初是 Gemini 3.8 Flash Cyber 搭配 CodeMender。Argon 是首个通过它发布的前沿模型,面向一批受信任的网络防御者。
为什么向防御者发布无网络防护栏的 Argon? Google 称受信任防御者与其内部团队可获无网络防护栏的模型,以使用完整的前沿级网络防御能力。这是一个深思熟虑的双用途取舍,也是访问由 Fairwind Program 的审查与治理把关、而非自助提供的原因。
Gemini 4 Argon 有模型卡吗? 截至发布时没有。DeepMind 模型卡索引列出了每一款已发布的 Gemini 与 Gemma 模型,其中没有 Gemini 4 Argon 条目,因此通常随模型卡一同发布的安全评估与已知局限尚未公布。
我该如何为 Argon 准备我的智能体技能? 把模型标识放进配置而非硬编码,让工作流的上下文组装与前缀保持稳定以便缓存生效,把检索到的文档当作不可信输入,并让生成的代码经过复核。然后在它可用的那天运行一组冻结的十任务对比。
资料来源
核对于 2026 年 9 月 30 日,即公告当日。资料仅限一手来源。
Google —— 一手来源
- Gemini 4 Argon: our next era of frontier intelligence —— Google 博客,发布文章
- Google's Fairwind Program: Cyber defense tools for trusted partners —— Google 博客,2026 年 9 月 2 日
- Fairwind Program —— Google DeepMind,项目条款与合作方数量
- Frontier safety at Google DeepMind —— Google DeepMind
- Introducing CodeMender: an AI agent for code security —— Google DeepMind
Gemini API —— 开发者文档
- Models —— ai.google.dev;Argon 未列出
- Gemini Developer API pricing —— ai.google.dev;没有 Argon 行
- Model cards —— Google DeepMind;没有 Argon 模型卡
官方社交账号
- X 上的 @GoogleDeepMind —— 发布帖与 1M token 帖
- X 上的 @Google —— 公告线程
- X 上的 @sundarpichai —— 防护措施与发布框架
站内
- 本文链接的注册表条目:
/skills/gemini-api、/skills/coding-agent、/skills/code-review、/skills/indirect-prompt-injection、/skills/cybersec-helper、/skills/secure-coding-cybersecurity、/skills/ai-cost-optimizer、/skills/category/security、/skills/category/coding、/clients/antigravity - 姊妹文章:《Gemini 3.8 Live 与 Extended Thinking》、《面向编程智能体负载的 GPT-6.1 Sol》、《We Must Pace the Frontier》、《什么是智能体技能?》