在 GPT-6 Astra、Sol 与 Luna 之间为智能体技能做模型路由
哪一档 GPT-6 该跑智能体技能流程的哪一步:价格、缓存的 SKILL.md 上下文、Codex 用量,以及一份按次运行的预算算例。
Agent Skills
智能体技能(agent skill)就是模型在行动之前先读一遍的 Markdown 文件,而重度使用技能的流水线要读很多。一次运行的每一步都带着同样的指令、同样的工具描述,往往还有同一份 SKILL.md 包,然后只做一点点新工作。这种形态对账单的影响,比哪个模型最聪明更大。OpenAI 现在卖三档 GPT-6,价格相差 5 倍和 100 倍,所以对基于技能搭建系统的人来说,实际问题不是“哪个模型最好”,而是“哪一步配用哪一档”。
本文针对整个系列回答这个问题:GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna。内容包括:各自的价格、重复出现的技能上下文如何计费、OpenAI 对不同模型编写技能的建议、Codex 用量在各模型间有何不同,以及一个 35 步流水线的按次运行预算算例。本文刻意不做基准对比。想看 Sol 的分数和适用负载,请读 GPT-6.1 Sol 面向编程智能体;想看 Ultrafast 与 Pro 套餐的算术,请读 Ultrafast 与 Pro 档位。若要了解 API 价格、发布日期和 Plus 额度的正面对比,AgentPedia 上的姊妹篇 GPT-6 Astra 完整指南有更详细的版本。
下文的价格、日期和用量区间均来自 OpenAI,核对于 2026 年 10 月 28 日,对照的是其定价页、模型页和帮助中心。路由规则和预算数字是本文自己的算术和建议。这里没有任何内容是在真实流水线上实测的,在关键处我会再次强调这一点。
三档模型一张表
三个模型的上下文窗口都是 1,050,000 token,所以上下文大小不是区分它们的因素。区分它们的是价格和 Codex 额度。价格为 Standard 处理下每百万 token 的价格。
| 模型(API ID) | 输入 | 缓存输入 | 输出 | Codex Plus 每 5 小时消息数(OpenAI 估算) | 在技能流水线中的角色 |
|---|---|---|---|---|---|
GPT-6 Astra (gpt-6-astra) | $10.00 | $1.00 | $50.00 | 5 到 45 | 规划,以及最难的步骤 |
GPT-6.1 Sol (gpt-6.1-sol) | $2.00 | $0.10 | $10.00 | 15 到 160 | 主力工作的默认选择 |
GPT-6 Luna (gpt-6-luna) | $0.10 | $0.01 | $0.50 | 350 到 3,000 | 便宜、高频、要求明确的步骤 |
OpenAI 定价页上有三条规则会改变真实账单。输入超过 272,000 token 的请求,整个请求的输入与缓存费率按 2 倍、输出费率按 1.5 倍计费。Batch 与 Flex 处理按 Standard 的 50% 计价。写入缓存按输入价的 1.25 倍计费(保留 30 分钟),保留 12 小时则是 2.5 倍。缓存价在 Astra 和 Luna 上是输入价的 10%,在 GPT-6.1 Sol 上是 5%,这就是为什么 Sol 的缓存价是 Astra 的十分之一,而不是五分之一。
OpenAI 在其模型页上还列出了 GPT-6.1 Terra,输入 1 美元、输出 5 美元,介于 Sol 与 Luna 之间。本文只在 OpenAI 定位为阶梯的三档之间做路由,把 Terra 当作需要另行评估的选项。
发布顺序解释了这条阶梯
这个系列不是一次性推出的,而发布顺序能看出 OpenAI 如何划分各自的角色。
GPT-6 Astra 于 2026 年 9 月 3 日(周四)宣布,先面向有限的组织,再分阶段推出。到 9 月 4 日,Sam Altman 说 Work 和 Codex 中的所有 Pro、Enterprise 与 Business Premium 用户以及 API 都已可用,Plus 和 Business 随后跟进。
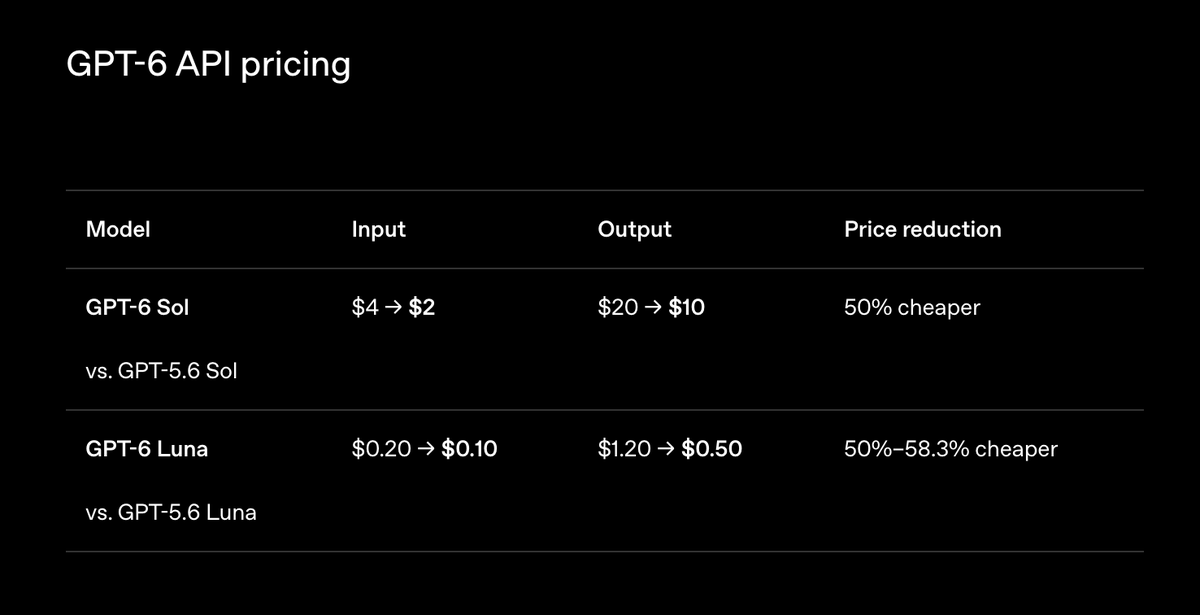
GPT-6 Sol 和 GPT-6 Luna 于 9 月 22 日(周二)在 ChatGPT Work、Codex 和 API 中上线,OpenAI 称其 API 价格比 GPT-5.6 低 50%。OpenAI 开发者账号的概括是“Build with Sol. Scale with Luna.”(用 Sol 构建,用 Luna 扩展)。
GPT-6.1 Sol 在 9 月 29 日(周二)、也就是 OpenAI DevDay 当天推出,token 价格与 GPT-6 Sol 同为 2 美元和 10 美元,缓存价从 0.20 美元降到 0.10 美元。Sol 和 Luna 都没有进入 Chat;它们在 Work、Codex 和 API 中。而 Astra 则是符合条件套餐里 Chat 中 GPT-6 Pro 背后的模型。
把它当作一条产品线来看,就是顶部一个规划者、中间一匹主力、底部一个走量的模型。本文接下来就把这条产品线变成针对技能的路由规则。
为什么技能流水线首先是个缓存问题
技能驱动的运行天生就是重复的。Codex 会把每个技能的名称和描述加载进上下文,让模型知道何时该用它,技能触发时再读完整的 SKILL.md。再加上 AGENTS.md、工具定义和系统提示,每一步最开头的几千个 token 都与上一步完全相同。
这正是提示缓存存在的意义。OpenAI 的 GPT-6 构建实用指南建议把稳定的指令和参考资料放在提示词开头,把变化的任务细节放在后面,并在估算整个工作流时把缓存写入和长上下文费率算进去。照做之后,重复的前缀在第一步之后的每一步都按缓存价计费。
这种效应的大小很容易算出来。假设一份 12,000 token 的技能包,在一次运行的 35 步中每步读取一次:
- 在 Astra 上,35 次读取按缓存价是 0.42 美元,未缓存是 4.20 美元。
- 在 GPT-6.1 Sol 上,缓存价是 0.042 美元,未缓存是 0.84 美元。
- 在 Luna 上,缓存价是 0.0042 美元,未缓存是 0.042 美元。
缓存写入是一次性的溢价。以 30 分钟保留期写入 12,000 token,Astra 要 0.15 美元,Sol 要 0.03 美元,Luna 要 0.0015 美元。由于溢价是输入价的 0.25 倍,而每次缓存读取节省输入价的 0.9 倍或 0.95 倍,所以在三档上,读取一次就能抵回写入成本。实际结论很简单:只要某个技能包在保留期内被读取不止一次,就应该缓存它,而你跑在哪一档,远不如前缀是否保持逐字节一致重要。
有两个习惯能守住这一点。把稳定的技能文本放在最前面,永远不要在它上方插入时间戳、运行 ID 或每个任务各自的细节。另外尽量让每个缓存前缀只对应一个模型,因为不能想当然地认为为某个模型缓存的前缀可以跨档复用。OpenAI 的定价页按模型描述缓存行为;在你检查自己的用量日志之前,请把跨模型复用当作未经证实的事。
OpenAI 对各档模型编写技能的建议
OpenAI 开发者博客文章“Rethinking skills and prompts for GPT-6 Astra”是目前关于这个话题最接近一手指导的材料,其中好几点都直接关系到路由。
文章说,现在人们把很多技能打包进项目,而每个技能的名称和描述都会加载进上下文。技能太多时,Codex 会缩短描述以适配,这样模型对每个技能看到的信息变少,选择也就更差。它的建议是让描述尽可能短,同时说明何时使用该技能。它给出的例子对比了“Use when working with databases, queries, models, or persistence”和“Use when adding or changing a migration, or reviewing its rollout.”。
它还推荐渐进式披露:让根目录的 SKILL.md 成为一个极简的路由器,指向支撑文档和脚本,让模型只读任务需要的部分。它还提醒,许多技能被写成了详尽的行程单,这可能妨碍善于处理细微差别的新模型。
对路由最关键的一句是:仓库里的技能也会指导其他贡献者的智能体,而那些智能体可能用的是不同的模型,对 Sol 或 Luna 有帮助的指导,可能会对 GPT-6 Astra 约束过度。换句话说,技能并不是与模型无关的。较小的模型需要的分步配方,对规划者来说可能太死板。OpenAI 的帮助中心补充了一点与推理强度相关的说法:“Astra at Low effort can outperform Sol at High effort”(低强度的 Astra 可以胜过高强度的 Sol),并建议如果高强度 Sol 对你有效,可以试试低或中强度的 Astra。这两条都是厂商的说法,本文都没有测试过。
对一个有路由的流水线,这意味着一种具体的设计。写简短、描述性的技能头部,让每一档都能读。让根文件做路由器。把死板的分步流程放在只有 Luna 档步骤才会加载的支撑文件里,让 Astra 的规划步骤看到目标和约束,而不是一份脚本。这样缓存前缀保持很小,也避免了按 Astra 的价格去读为更便宜模型写的指令。
常见技能的路由图
下面的技能都是 agentskills.codes 注册表里的真实条目。各档的分配是本文基于步骤形态和已公布价格给出的建议,不是基准测试结果。跑过你自己的任务之后再调整。
Luna 步骤:范围窄、重复、“正确”的标准明确。 围绕文档的格式转换和提取,例如 pdf、docx 和 xlsx 技能,基本上是机械性的:取出文本、重写单元格、产出结构化结果。OpenAI 自己的指南把提取发票字段、对请求分类和生成结构化摘要列为 Luna 擅长的工作。决定该加载哪个技能的分流步骤,以及像“测试命令是否以零退出”这样的检查,也同理。
Sol 步骤:主力工作。 在纪律类技能约束下的实现是最核心的情形。test-driven-development 和 systematic-debugging 都涉及在一个庞大且基本稳定的上下文上进行大量工具调用,这正是 Sol 的 5% 缓存价最划算的地方。webapp-testing 针对本地应用运行类似的循环。OpenAI 的指南把 Sol 指向复杂编码、研究和计算机操作,而本文对经常运行的多步骤工作的默认选择就是 Sol。
Astra 步骤:规划,以及别的模型都攻不下的失败。 writing-plans 和 brainstorming 产出后续每一步都要遵循的产物,所以这里的错误会被放大。在高风险工作上最后做一遍 verification-before-completion 是另一个候选。一个合理的升级规则是:任务在 Sol 上失败两次之后才送去 Astra,这样 Astra 的溢价只花在真正需要的任务上。
编排。 像 dispatching-parallel-agents 和 subagent-driven-development 这样的技能描述的是把工作拆给多个子智能体。路由在这里变成了字面意义上的事情:协调者可以跑在一档,工作者跑在另一档。OpenAI 说 GPT-6.1 Sol 支持 Responses API 中的多智能体工作流,目前处于 beta。按工作者选模型,让便宜的工作者用 Luna。
编写。 skill-creator 是 OpenAI 文章点名的通常用来创建技能的技能,文章说其指导已更新,以应对上述失败模式。常规技能用 Sol 来做,当技能编码了微妙的策略时,可以考虑 Astra。mcp-builder 也类似,需要判断,因为一个设计糟糕的工具 schema 会拖累之后的每一步。
一份按次运行的预算算例
下面的数字使用官方 Standard 价格和假设的工作负载形态。它们是算术,不是实测,你的 token 数会有出入。推理 token 按输出计费,所以在高强度下,真实的输出量会高于可见文本。
假设的流水线每次运行有 35 步,每步都带一个缓存前缀,其中包含一份 12,000 token 的技能包:
| 步骤类型 | 数量 | 档位 | 未缓存输入 | 缓存输入 | 输出 | 每次运行成本 |
|---|---|---|---|---|---|---|
| 分流 | 6 | Luna | 1,000 | 14,000 | 300 | $0.0023 |
| 格式转换与提取 | 20 | Luna | 800 | 14,000 | 400 | $0.0084 |
| 主力工作 | 8 | Sol | 6,000 | 60,000 | 3,000 | $0.3840 |
| 规划或难步骤 | 1 | Astra | 8,000 | 40,000 | 6,000 | $0.4200 |
| 路由后总计 | 35 | $0.8147 |
现在对比同一次运行在单一模型分配下的情况,全部都在缓存生效的前提下:
| 分配方式 | 每次运行成本 | 每天 500 次运行 |
|---|---|---|
| 全部用 Astra | $3.654 | $1,827.00 |
| 如上路由 | $0.8147 | $407.37 |
| Luna、Luna、Sol、Sol(不用 Astra) | $0.4747 | $237.37 |
| 全部用 Sol | $0.6424 | $321.20 |
| 全部用 Luna | $0.0365 | $18.27 |
有两个结果值得直说。第一,路由比全用 Astra 便宜约 78%,这正是大多数人预期的节省。第二,这套路由设计比全用 Sol 贵约 27%,因为单独一个 Astra 规划步骤要 0.42 美元,而同一步在 Sol 上只要 0.08 美元。规划步骤占了路由后账单的 52%。把 Astra 放进循环,是有意地购买质量,而不是节省,这张表的作用就是让你判断,这一步值不值五倍的价格。如果 Sol 在你的任务上规划得一样好,那么最便宜又合理的流水线就是 Luna、Luna、Sol、Sol 那一行。
缓存带来的改变比档位选择更大。不用缓存的话,同样的路由运行成本是 2.12 美元,全用 Astra 是 11.61 美元,全用 Sol 是 2.32 美元。启用缓存的路由流水线,比没有缓存的全 Sol 流水线还便宜。这就是为什么对重度使用技能的系统来说,第一项优化是前缀稳定性,第二项才是档位分配。
还有一项成本要留意,就是 272,000 token 这条线。越过它,整个请求就按输入 2 倍、输出 1.5 倍计价,所以一份不断膨胀、直到工作上下文越线的技能包,会让某一步远比其 token 数所暗示的更贵。宁可裁剪上下文,也不要为这个倍数买单;如果某一步确实需要大上下文,就为它单独做一次档位决策。
模型共用池时的 Codex 用量
如果你的流水线是在 ChatGPT 套餐的 Codex 里跑,而不是通过 API,那么你付的就不是 token。OpenAI 帮助中心说,Work 与 Codex 的用量“并不对应固定数量的消息或任务”,并给出了 Plus 与 Standard Business 在五小时窗口内本地消息数的估算区间:Astra 5 到 45,GPT-6.1 Sol 15 到 160,Luna 350 到 3,000。这些区间是 OpenAI 的估算,云端任务消耗的额度可能高于本地消息。Plus 还有每周窗口,所以两个窗口里都得有余量。
对路由有两点要注意。这些模型共用同一个 Work 与 Codex 用量池,所以把某一步降到 Luna,只会让剩余额度撑得更久,不会把某个 Astra 步骤已用掉的额度补回来。另外,各档之间的比例并不等同于 API 价格比:Sol 的区间大约是 Astra 的 3 到 3.6 倍,而 Luna 的区间大约是 Sol 的 19 到 23 倍,这接近 Sol 与 Luna 之间 20 倍的 API 价差。这种解读是本文基于 OpenAI 表格的算术,不是 OpenAI 的说法。
对 Codex 中的子智能体工作来说,结论和 API 预算是一样的。让规划者成为少见而昂贵的调用,让主力工作者用 Sol,让大量的小步骤用 Luna。如果 Plus 订阅用户把每个子智能体都跑在 Astra 上,就是在把三份额度里最小的那份,花在最不需要它的工作上。
套餐结构也会改变限额。Pro 100、Pro 200 和 Pro 500 目前在 Work 和 Codex 中没有五小时限制,而 Ultrafast 在发布时仅包含在 Pro $500 中。这些细节见 Ultrafast 与 Pro 档位指南,此处不再重复。
该用哪个 Luna:GPT-5.6 还是 GPT-6
如果你的技能还固定在旧的模型 ID 上,Luna 的对比看似简单,却很容易算错。在 OpenAI 2026 年 7 月 30 日降价之后,GPT-5.6 Luna 的标价是输入 0.20 美元、缓存 0.02 美元、输出 1.20 美元。GPT-6 Luna 是 0.10 美元、0.01 美元和 0.50 美元。也就是说,GPT-6 Luna 的输入价是一半,输出价大约便宜 58%。
在上面的预算里,Luna 步骤在 GPT-6 Luna 上每次运行成本是 0.0107 美元。如果换成 GPT-5.6 Luna,同样的步骤大约要 0.0234 美元。两个数字都很小,这正是 Luna 步骤的意义所在,但在高并发下,这个比例会不断累积。没有价格上的理由在 GPT-5.6 Luna 上开展新的技能工作。保留它的理由是兼容性,以及一套你不想重做的现有评测集。
有路由的技能流水线里的失败模式
路由增加了活动部件,而大多数问题都出在那几个相同的地方。
前缀漂移。 提示词靠近顶部的单个字符发生变化,就会让每一次缓存读取变成全价读取。常见原因有时间戳、请求 ID、被打乱的工具顺序,以及每次运行排序不一致的技能列表。把稳定块放最前面,排序要确定,并记录缓存与未缓存的 token 数,这样比例下降时你才能发现。
技能描述膨胀。 OpenAI 自己的建议是,技能太多会让 Codex 缩短描述,导致模型选择变差。为每一步都加一个特定于档位的技能,会让这个问题成倍放大。宁可用一个带路由根文件的技能,也不要五个近乎重复的技能。
对规划者约束过度。 为 Luna 写成死板配方的技能,可能让 Astra 停下来请求许可,或者在你本来乐意它继续时按兵不动。把特定档位的流程放在只有该档位才会加载的文件里。
悄无声息的升级。 一条没有上限的“失败即升级”规则,可能把一条廉价流水线变成一条 Astra 流水线。要给重试设上限,记录每一步由哪一档处理,并像预算表那样报告各档的花费占比。
越过 272K 的上下文。 粘贴进历史的长工具输出,可能把某一步推过长上下文这条线。在工具结果进入主上下文之前,先用 Luna 做摘要,这也是 Luna 最便宜、最有用的工作之一。
承诺之前如何测试路由方案
这篇文章里没有任何数字来自真实流水线,所以最后一步要靠你自己。从你自己的待办清单里取 30 到 50 个真实任务,每个都用三种设置各跑一遍:全部用 Sol、上述路由方案,以及只在规划步骤用低强度的 Astra。记录通过率、token 数、缓存占比和每个通过任务的成本,而不是每次调用的成本。如果在某类任务上,Sol 的规划与 Astra 一样好,就把 Astra 从这一类里去掉。如果 Luna 能通过某类步骤的大多数,就把这类步骤路由给 Luna,失败的再往上送。如果某一步在三种设置下都失败,问题出在技能或任务定义上,而不是档位。
每一步都记录档位,每次运行都记录缓存 token 占比。下个季度价格或模型再次变化时,正是这两列数据让你能回答问题。
结论
技能流水线默认跑在 GPT-6.1 Sol 上,因为大多数智能体工作是多步骤的、经常运行的,并且带着庞大的稳定前缀,这正是 Sol 的 5% 缓存价以及 2 美元和 10 美元的 token 价格最合适的地方。把大量小而明确的步骤下放到 GPT-6 Luna:文档转换、分流、简短编辑和检查。把 Astra 用在规划步骤,以及已经在 Sol 上失败过的任务上,并且用类似上面那样的表来决定这笔开销,而不是凭直觉,因为一个规划步骤 0.42 美元对 0.08 美元,这是路由后账单里最大的单项。
先缓存技能包,再做路由。稳定的前缀对账单的帮助,比任何档位选择都大,而缓存写入的成本在第一次读取时就能收回。
常见问题
我的智能体技能默认该跑哪个 GPT-6 模型?
GPT-6.1 Sol。它是每百万输入 token 2 美元、缓存 0.10 美元、输出 10 美元,OpenAI 的指南把它指向复杂编码、研究和计算机操作。步骤范围窄且要求明确时,往下放到 Luna;任务在 Sol 上失败或出错代价高时,往上放到 Astra。
缓存一份 SKILL.md 包能省多少?
在假设的流水线上,一份 12,000 token 的包被读取 35 次,在 Sol 上未缓存是 0.84 美元,缓存是 0.042 美元,节省 95%。在 Astra 上分别是 4.20 美元和 0.42 美元。缓存写入按输入价的 1.25 倍计费(保留 30 分钟),在三档上,一次缓存读取就能还清这笔溢价。
规划步骤值得用 Astra 吗?
在这个算例里,这一步的成本大约是 Sol 的五倍(每次运行 0.42 美元对 0.08 美元)。值不值取决于 Sol 的规划在你的任务上失败的频率。OpenAI 说低强度的 Astra 可以胜过高强度的 Sol,这是一条厂商说法,值得先在你自己的仓库上测试,再决定是否到处付这笔钱。
Astra、Sol 和 Luna 共用 Codex 用量吗?
共用。OpenAI 说 Work 和 Codex 的模型从同一个用量池扣减,所以切到 Luna 会让剩余额度撑得更久,但不会补回你已经花掉的部分。Plus 每五小时的估算区间是:Astra 5 到 45 条消息,GPT-6.1 Sol 15 到 160 条,Luna 350 到 3,000 条,OpenAI 称它们是估算,不是配额。
GPT-5.6 Luna 和 GPT-6 Luna 有什么区别?
7 月 30 日降价后,GPT-5.6 Luna 是每百万 token 输入 0.20 美元、输出 1.20 美元。GPT-6 Luna 于 9 月 22 日发布,价格为 0.10 美元和 0.50 美元。因此 GPT-6 Luna 的输入价是一半,输出价约便宜 58%,上下文窗口同为 1.05M。
不同的模型,技能该写得不一样吗?
OpenAI 的说法是部分如此。写成详尽分步配方的技能可能妨碍新模型,而对 Sol 或 Luna 有帮助的指导可能对 Astra 约束过度。让技能描述保持简短,让根文件做路由器,把死板的流程放进只有较便宜一档才会加载的支撑文件里。
长技能上下文什么时候会变贵?
在 272,000 个输入 token 时。超过这个数,整个请求就按输入与缓存费率 2 倍、输出 1.5 倍计费。在大型工具结果进入主上下文之前先做摘要,并让技能包小到使工作上下文保持在这条线以下。
这篇文章包含基准测试吗?
没有。想看 Sol 的智能体基准及其配置,请读 GPT-6.1 Sol 面向编程智能体。想看围绕 6.1 Sol 发布的 OpenAI DevDay 公告,请见 面向智能体开发者的 DevDay 回顾。
资料来源
核对于 2026 年 10 月 28 日。
- OpenAI API 定价:https://developers.openai.com/api/docs/pricing
- Introducing GPT-6 Astra:https://openai.com/index/gpt-6-astra/
- Introducing GPT-6 Sol and Luna:https://openai.com/index/introducing-gpt-6-sol-and-luna/
- Introducing GPT-6.1 Sol:https://openai.com/index/introducing-gpt-6-1-sol/
- GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna、GPT-5.6 Luna 与 GPT-6.1 Terra 的模型页:https://developers.openai.com/api/docs/models/gpt-6-astra
- Managing usage with GPT-6 Astra in Work and Codex:https://help.openai.com/en/articles/20001516-managing-usage-with-gpt-6-astra-in-work-and-codex
- Practical guide to building with GPT-6:https://openai.com/index/practical-guide-building-gpt-6/
- Rethinking skills and prompts for GPT-6 Astra(OpenAI 开发者博客):https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra
- Advancing the price-performance frontier with GPT-5.6:https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
- 上文嵌入的 X 帖子:@OpenAI(9 月 29 日)、@sama(9 月 4 日)和 @OpenAIDevs(9 月 22 日)
观看发布视频
OpenAI 面向开发者的发布视频只涵盖 Astra,因为它早于 Sol 和 Luna。


