面向智能体技能的 Kimi K3.1 Pro:配置、单次运行成本与速率限制
在 Kimi K3.1 Pro 上运行 SKILL.md 工作流与子智能体:工具链配置、技能单次运行成本推算、缓存影响、API 档位与订阅配额。
Agent Skills
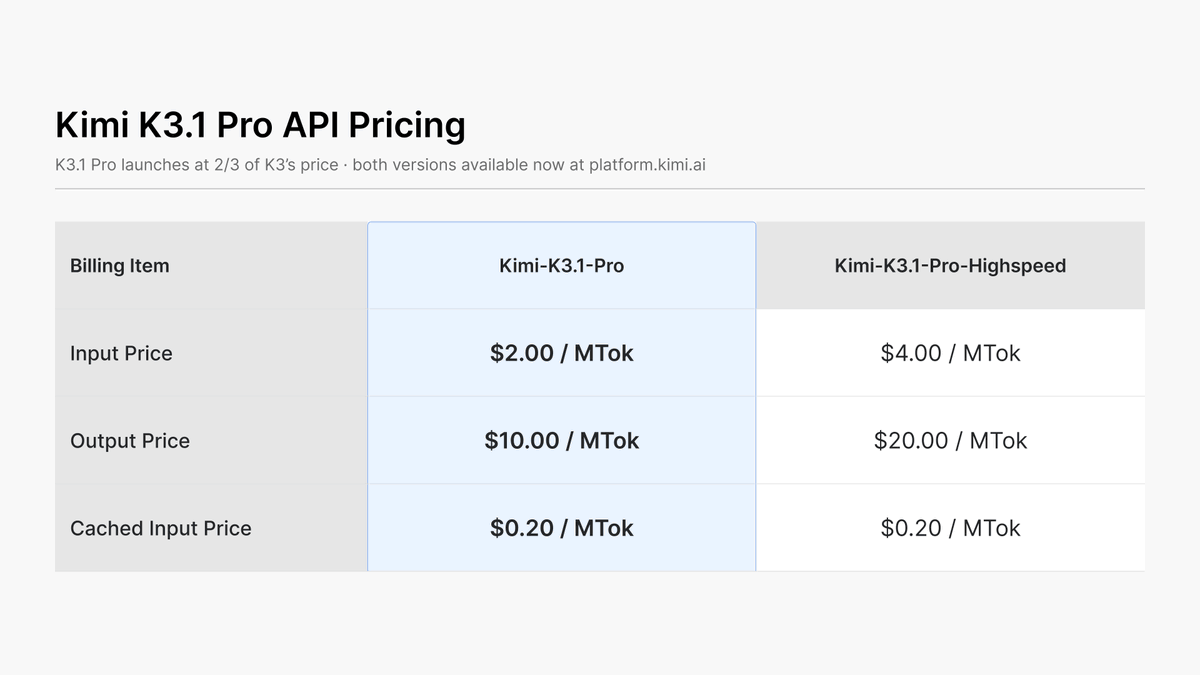
月之暗面(Moonshot AI)在 2026 年 10 月 23 日发布了 Kimi K3.1 Pro。对于运行智能体技能(agent skills)的人来说,值得关注的并不是排行榜上的名次,而是:一次技能调用花多少钱,一个套餐能撑住多少个子智能体,以及哪些工具链设置能让 SKILL.md 工作流在 Kimi 上和在其他模型上表现一致。官方标价为每百万输入 token $2.00、每百万输出 token $10.00、每百万缓存输入 token $0.20,Highspeed 版本为 $4.00 和 $20.00。两个版本的上下文窗口都是 1,048,576 token。
本文把这个模型当作技能的运行时来看。内容包括:把现有工具链指向 K3.1 Pro 的三种官方文档路径;Kimi 自家 CLI 中技能与子智能体的行为;四种技能形态的成本推算表;决定能同时跑多少子智能体的 API 速率限制档位;以及订阅配额规则,其中包括月之暗面在发布两天后发出的致歉。所有价格和限额都来自月之暗面的页面。每一个技能运行的美元数字,都是用官方价格对我们假设的 token 数做的算术,文中均有标注。这里的一切都不是我们实际运行的结果,所以没有实测的延迟或成功率。
给技能作者的简短结论
三个事实决定了大部分设计。
第一,缓存输入的价格是普通输入的十分之一。如果一个技能在每一步都重新读取相同的指令、参考文件和仓库上下文,那它大部分时间支付的是缓存价。如果技能每一轮都改写自己的提示词前缀,就要按全价付费。
第二,输出价格是普通输入的五倍,而 K3.1 Pro 的思考模式始终开启。reasoning_effort 参数接受 low、high 或 max,默认值是 max。做分类或格式化的技能不需要默认值。
第三,每个子智能体都是独立的上下文,各自消耗 token。Kimi 的文档直接这样说明,而月之暗面在 10 月 25 日的帖子里也提到,正在减少订阅套餐中不必要的子智能体调用。扇出(fan-out)就是需要盯紧的成本乘数。
K3.1 Pro 能在哪里运行你的技能
月之暗面记录了好几条路径。下表从技能作者的角度列出:SKILL.md 文件从哪里读取、模型 ID 是什么、费用怎么算。
| 路径 | 技能发现方式 | 模型 ID | 计费 |
|---|---|---|---|
| Kimi Code CLI | 扫描项目、用户、额外和内置技能目录 | 用 /model 选择 | 会员配额,Plus 及以上 |
| 通过 Kimi Code 使用 Claude Code | Claude Code 自带的技能与子智能体加载 | k3.1-pro 或 k3.1-pro[1m] | 会员配额 |
| 通过平台端点使用 Claude Code | Claude Code 自带加载 | 指南示例使用 kimi-k3[1m] | 按 token 付费 |
| Codex | Codex 自带加载 | kimi-k3.1-pro | 按 token 付费 |
| 你自己的 API 循环 | 取决于你怎么写 | kimi-k3.1-pro 或 kimi-k3.1-pro-highspeed | 按 token 付费 |
技能如何被找到、如何被调用,由工具链决定。模型看到的只是最终生成的提示词。这种分离很有用:为某个工具链写的技能不会因为背后的模型换了而改变,但模型在工具调用和长上下文上的行为可能会变。月之暗面发布材料中的编程成绩是在 Claude Code 工具链下报告的,所以对于已经有现成技能库的人,Claude Code 是文档最完整的搭配。
Kimi Code CLI:技能就是文件
Kimi Code CLI 把一个技能视为带 YAML frontmatter 的 Markdown 文件。推荐使用目录形式:以技能名命名的文件夹,里面放一个 SKILL.md,旁边可以放脚本或参考文件。直接把一个扁平的 .md 文件放进技能目录也能注册,名称取自文件名,但它没有自己的文件夹,因此无法携带配套文件。
发现机制按作用域进行。CLI 扫描四个层级,更具体的层级优先:项目、用户、config.toml 中声明的额外目录,最后是内置技能。项目技能位于包含 .git 的最近目录下的 .kimi-code/skills/ 或 .agents/skills/。用户技能位于 ~/.kimi-code/skills/ 或 ~/.agents/skills/。~/.agents/skills/ 与其他智能体工具使用的是同一约定,所以放在那里的技能库是共享的,而不是复制一份。
frontmatter 的字段不多。目录形式下 name 和 description 都是必填,缺任何一个都会解析失败。description 是模型用来决定是否调用技能的那一行,等于触发条件,值得写成一条决策规则,而不是一个标题。whenToUse 提供第二层提示。type 默认是 prompt,inline 的行为相同,flow 表示只能手动调用。设置 disableModelInvocation: true 会阻止自动调用。具名的 arguments 会变成正文里的 $name 占位符,${KIMI_SKILL_DIR} 会解析成技能所在文件夹,这样正文就可以指向自己的参考文件。
调用方式要么手动,使用 /skill:<name> 加可选参数,要么根据描述自动调用。技能调用最多可以嵌套三层,超过会被终止。就成本而言,嵌套上限没有下面这一点重要:每个被嵌套的技能都会把自己的正文加进上下文,而每多出来的 token 会按输入写入、缓存命中还是全价输入计费,取决于前缀是否匹配。
如果你要为多个工具链维护技能,注册表里已经有覆盖这部分的页面:介绍 CLI 本身的 kimi-cli-help,介绍如何把 Kimi 接入其他工具的 kimi-integration,以及从零编写 SKILL.md 的 skill-creator。
在 K3.1 Pro 上运行 Claude Code
月之暗面提供了两份各自独立的 Claude Code 指南,它们在模型名称上并不一致,所以要读和你的密钥相匹配的那一份。
Kimi Code 文档面向会员密钥。它把 ANTHROPIC_BASE_URL 指向 https://api.kimi.ai/coding/,模型使用 k3.1-pro 或 k3.1-pro[1m]。它的 settings.json 配置块设置了主模型、默认的 Fable、Opus、Sonnet 和 Haiku 槽位、子智能体模型、思考强度,以及两个上下文变量:
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.kimi.ai/coding/",
    "ANTHROPIC_API_KEY": "Your API Key",
    "ANTHROPIC_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_FABLE_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "k3.1-pro[1m]",
    "CLAUDE_CODE_SUBAGENT_MODEL": "k3.1-pro[1m]",
    "CLAUDE_CODE_EFFORT_LEVEL": "high",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1048576",
    "CLAUDE_CODE_MAX_CONTEXT_TOKENS": "1048576"
  }
}这个配置块里有两项对技能库很重要。CLAUDE_CODE_SUBAGENT_MODEL 决定所有子智能体使用哪个模型。把它指向和主循环相同的 K3.1 Pro 是最简单的选择,但这也意味着每个被委派的任务都按 K3.1 Pro 的价格计费。该配置块还把 Haiku 槽位映射到了 K3.1 Pro,所以平时会把小任务发给更便宜档位的工具链,在这里发给了同一个模型。如果你的技能依赖这种路由来控制成本,除非你修改映射,否则这种路由就没有了。月之暗面的示例中,思考强度变量设置为 high 而不是 max,这个杠杆会在成本部分讨论。
上下文数字取决于套餐。Kimi Code 页面把 262,144 token 窗口的 k3.1-pro 对应到 Plus,把 1,048,576 token 窗口和 k3.1-pro-highspeed 对应到 Pro 及以上。自动压缩窗口应当与你实际拥有的上下文一致,否则工具链要么压缩得过早,要么试图容纳套餐不允许的长度。月之暗面还说明只能选一种配置方式:要么用设置文件,要么用导出的环境变量,不要两者并用。
平台指南面向按量付费的密钥。它使用 https://api.moonshot.ai/anthropic 作为基础 URL,并以 ANTHROPIC_AUTH_TOKEN 传递密钥。它的示例模型是 kimi-k3[1m],这是 K3,不是 K3.1 Pro。从我们读到的页面里,无法确认在该端点上用哪个模型字符串能选中 K3.1 Pro,所以稳妥的做法是,在让技能库依赖它之前,先用你打算使用的模型字符串发一次测试调用。关于用 Claude Code 对接其他模型的更广泛视角,可以先看注册表里的 claude-code 页面。
Codex 与原生 API
月之暗面的 Codex 指南使用一个 provider 配置块,以 Responses 的传输格式调用兼容 OpenAI 的端点:
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"指南解释说,model_context_window 必须与 1M 窗口一致,否则 Codex 会对未知模型回退到默认的元数据。对于自定义循环,快速入门使用 OpenAI Python SDK 访问 https://api.moonshot.ai/v1。手写智能体循环最容易踩的坑是多轮状态:快速入门的工具调用部分要求,把完整的助手消息返回给下一次请求,并为每个调用补上一条带有匹配 tool_call_id 的工具结果。如果运行器只用文本重建助手这一轮,就偏离了这条说明,而我们没有测试过这会让质量损失多少。注册表中的 codex-subagent 页面介绍了 Codex 一侧的委派模式。
子智能体:隔离既是成本特性,也是成本
Kimi Code CLI 自带三个内置子智能体。coder 是默认的通用子智能体,可以读写文件并运行命令。explore 是只读的,用来搜索和总结仓库。plan 没有 shell 权限,用于设计工作。三者都不能再派发子智能体,而自定义智能体继承相同的允许列表,除非它声明了自己的 subagents 列表,所以委派链默认会终止。
每个子智能体运行在自己的上下文窗口里。它只能看到主智能体传给它的任务描述,只有它的最终结果会流回主智能体。这是它的好处:长会话不会被探索性日志填满,多个子智能体可以并行运行。代价在文档的同一节里写明了:每个子智能体都独立消耗模型 token,对于简单任务,由主智能体处理更经济。
对技能设计来说,这可以转化成一条规则。当工作量大、可并行或噪音多时再委派,比如为了回答一个问题去读一百个文件;当工作只是一次快速编辑时,就保留在当前上下文里。一个正文写着「总是先启动一个 explorer」的技能,每次运行都要为一个全新的上下文付费,哪怕答案只在一个文件里。下面的成本表给出了具体数字。
自定义智能体是带 frontmatter 的 Markdown 文件:包括指导委派的 description、可选的 whenToUse、tools 允许列表、disallowedTools 禁止列表,以及可选的 subagents 允许列表。文档指出,未知字段会被忽略,来自其他工具的字段(比如 Claude Code 的 model)会被跳过,逗号分隔的 tools 写法让 Claude Code 风格的智能体文件仍可加载。只有一个描述和正文的最小文件可以跨工具使用。在实践中,这意味着为某个工具链写的智能体库,可以不加改写地拿到 Kimi Code CLI 上试用,不过凡是依赖单个智能体指定模型的做法都无法延续过来。
文档里还有一条安全提示,技能作者应该读一读。智能体文件是提示词配置,而项目级文件来自仓库本身。一个名为 agent.md 且带有 override: true 的项目文件,会替换默认主智能体的整个系统提示词,coder.md 带同样的标记则会替换默认子智能体。没有 tools 列表的文件会保留所有工具。月之暗面的建议是,在不熟悉的仓库里运行 CLI 之前,要像检查脚本一样审查 .kimi-code/agents/ 和 .agents/agents/。如果你通过仓库共享技能,请把改动这些文件夹的拉取请求当作代码审查,而不是文档审查。
与工具链无关的编排模式,可以参阅注册表中的 subagent-driven-development。
每次技能运行的成本
下面的场景是四种技能形态,token 数是我们选定的合理取值,而不是实测值。价格使用月之暗面的标价。未缓存输入按普通价格计费,缓存输入按每百万 $0.20 计费,示例中不计 1 小时缓存写入。请把这些美元数字当作观察结构的方式,并用你自己的用量字段中的数字替换 token 数。
| 技能形态(假设的 token) | K3.1 Pro | Highspeed | K3 对照 |
|---|---|---|---|
| 提交信息技能:12K 输入,无缓存,1.5K 输出 | $0.039 | $0.078 | $0.0585 |
| PR 审查技能:40K 输入,160K 缓存,8K 输出 | $0.192 | $0.352 | $0.288 |
| 同一个 PR 审查但无缓存命中:200K 输入,8K 输出 | $0.480 | $0.960 | $0.720 |
| 一个 explorer 子智能体:30K 输入,10K 缓存,4K 输出 | $0.102 | $0.202 | $0.153 |
| PR 审查加三个 explorer 子智能体 | $0.498 | $0.958 | 未计算 |
| 大型重构技能:100K 输入,900K 缓存,60K 输出 | $0.980 | $1.780 | $1.470 |
这张表可以读出四点。
PR 审查在有缓存命中时便宜 2.5 倍,$0.192 对 $0.480,模型相同,任务相同。变化的不是模型价格,而是提示词的布局。把技能正文、参考文件和仓库上下文以固定顺序放在提示词最前面,把变化的 diff 放在最后。
给这次审查再加三个 explorer 子智能体,账单大约乘以 2.6,从 $0.192 涨到 $0.498,子智能体约占总额的 61%。每个子智能体都是冷启动,缓存很小,所以它的输入大多按全价计费。如果这些子智能体各自读取不同的文件,这笔钱买到的是真正的并行阅读;如果它们都重复读同样的五个文件,这笔钱买到的东西,主智能体一遍就能完成。
在有缓存的 PR 审查上,Highspeed 的价格是标准价格的 1.83 倍,而不是 2 倍,因为两者的 $0.20 缓存命中价相同。对于有人在等的技能,这笔溢价很容易说得通;对于在很多仓库上夜间批量运行同一个技能,就不划算。
在上述每种形态上,K3.1 Pro 都比 K3 便宜,幅度正是标价所说的三分之一。Artificial Analysis 发现,K3.1 Pro 每个任务使用的输出 token 比 K3 多约 14%,而它每个指数任务的成本大致持平,为 $1.98。如果新模型写得更多,价格下调三分之一并不等于成本下降三分之一。在假设有节省之前,请在你自己的技能上测量输出 token。
要把单次成本换算成月度数字,乘以调用量即可。按每天 20 次、每月 22 个工作日计算,也就是 440 次,标准模型上 PR 审查每月约 $84,带三个子智能体的审查约 $219。同样的扇出在 Highspeed 上约为 $422。这些是对假设输入做的算术,不是预测。
输入里有多少来自缓存
缓存行为是最大的变量,也是技能作者能控制的变量。下一张表把 PR 审查的形态固定在 200K 输入 token 和 8K 输出 token(标准模型),只改变输入中由缓存提供的比例。
| 由缓存提供的输入比例 | 每次运行成本 |
|---|---|
| 0% | $0.480 |
| 50% | $0.300 |
| 80% | $0.192 |
| 90% | $0.156 |
我们在 10 月 28 日抓取 OpenRouter 上月之暗面线路的页面时,它显示缓存命中率为 91.4%,加权平均输入价格为每百万 token $0.3546。这是整个市场层面的平均值,说明智能体流量总体上缓存效果好,并不代表你的技能也会如此。一个把时间戳或运行 ID 写进提示词第一行的技能,每次调用都会破坏前缀。一个每次都把同一个 30,000 token 的参考块放在最前面的技能,则能保持命中。
缓存写入有自己的价格。5 分钟有效期的写入与普通输入同价,每百万 $2.00,1 小时有效期的写入为 $4.00。对于每隔几分钟就调用一次的技能,短有效期就够用。对于每小时运行一次的技能,只有长有效期的写入才能获得命中,而第一次调用要付双倍。
把思考强度作为每个技能的设置
由于思考模式始终开启,强度参数就是直接控制输出 token 的把手。月之暗面自己的基准脚注说明,K3.1 Pro 的成绩是在 max 强度下得到的,所以公布的分数对应的是最贵的设置。月之暗面没有公布在 low 或 high 下质量会怎样变化。
合理的做法是为每个技能单独设置强度,然后测试。做分类、路由、字段提取或文本格式化的技能,可以考虑 low。做代码审查、变更规划或调试的技能,可以考虑 high 或 max。测试方法是在一组固定的自有输入上,用两档强度各跑一遍每个技能,比较的是每个被接受结果的成本,而不是每次调用的成本。一次便宜但失败又重试的调用,比一次昂贵但成功的调用花得更多。注册表中的 ai-cost-optimizer 和 budget-optimizer 页面介绍了预算方面的内容。
我们之前关于其他厂商档位的文章,用不同的价格给出了同样的推理思路:面向编程智能体的 GPT-6.1 Sol 演算了缓存输入的算术,Ultrafast 与 Pro 档位 讨论了为速度付费,面向智能体技能的 GPT-6 模型路由 讨论了把不同技能发给不同模型。
API 速率限制及其对子智能体的影响
API 的限额取决于累计充值金额,并按账户生效。月之暗面的限额页面列出了并发数、每分钟请求数、每分钟 token 数和每日 token 数。
| 档位 | 累计充值 | 并发 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | 不限 |
| Tier2 | $20 | 40 | 100 | 3,000,000 | 不限 |
| Tier3 | $100 | 50 | 200 | 3,000,000 | 不限 |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | 不限 |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | 不限 |
对于子智能体工作流,首先要看的是并发这一列。一个并行扇出四个子智能体的工具链,至少需要四个并发请求,再加上主循环自己的请求。在 Tier0,并发为 1、每分钟请求数为 3,所以并行子智能体无法真正并行,多步骤技能的大部分墙钟时间都花在等待上。Tier1 只需累计充值 $10,就把并发提高到 15、每分钟请求数提高到 100,足以支撑适度的扇出。
第二个约束是 token 列。在我们的例子中,单个 PR 审查请求的输入约为 200K token。如果 TPM 把完整的提示词都计入(我们读到的页面没有写明这一点),那么 2,000,000 的 TPM 限额,在你所有子智能体合计下,每分钟大约允许十个这样的请求,不论其中大部分提示词是否来自缓存。我们无法从页面上确认缓存 token 是否计入限额,所以把十这个数字当作最保守解读下的上限。
页面上还有几条规则。开始使用需要至少充值 $1,累计充值达到 $5 时赠送 $5 代金券,代金券不计入累计总额。超过限额会返回 HTTP 429。当集群负载达到上限时,月之暗面可能临时调整限额,检测到异常活动会触发风控限流,且无法解除。该页面没有按模型列出限额,所以我们不能说 K3.1 Pro 与平台上其他模型是否共享同样的上限。
在技能运行器中处理 429 时,应当退避并降低并发,而不是用同样的宽度重试。把四个并行的子智能体在同一时刻再重试一次,很可能只会换来四个新的 429。
订阅配额是另一笔预算
Kimi Code 会员配额与 API 计费是分开的。对新会员来说,每周配额限制已经取消;剩下的是滚动 5 小时速率窗口和月度总额。旧版套餐仍然从订阅日期起每七天刷新一次。一个账户下所有已登录的设备和 API 密钥共用同一份配额,来自 CLI、VS Code、桌面应用和第三方工具的请求都会计入。配额用完后,可以用额外用量(Extra Usage)余额继续工作,它最后扣除,并可选设置每月消费上限。月之暗面表示,额外用量的价格接近其 API 价格,对于重度使用,升级到更高套餐通常更划算。
在我们读到的页面中,月之暗面的会员文档没有公布各套餐的绝对 token 额度,所以我们无法把配额换算成技能运行次数。它在额外用量计费中给出了两个规模参照:一个简单请求大约花 0.03 元,一个复杂的多步骤任务大约花 1.6 元,两者都被描述为大致的官方示例。
发布两天后,月之暗面发了一条致歉帖,对在订阅上运行技能的人很重要。
帖子说,一次性重置会恢复月度配额的 25%,相当于一周的用量,同时月之暗面调整了套餐参数,并在减少不必要的子智能体调用和输出长度。可以把它理解为官方的一份声明:发布时的配额消耗高于预期,子智能体扇出是原因之一。如果你把技能安排在订阅配额上运行,请在最初几周从 Kimi Code 控制台记录消耗,并预期数字会变化。
Codex 一侧有类似的情况,见 Codex 用量限制与智能体工作流。
一个注重成本的技能模板
下面的技能是我们为说明成本控制放在哪里而写的示例,没有实际运行过。它使用文档中记录的 frontmatter 字段,并把稳定的内容放在正文顶部。
---
name: review-pr
description: Review a pull request against the team checklist and return a severity-ranked report. Use for diffs under about 2,000 changed lines.
whenToUse: When the user asks for a PR review or a diff check
arguments:
  - pr_ref
---

Review the pull request given as $pr_ref.

Read the team checklist at ${KIMI_SKILL_DIR}/references/checklist.md first.
Do not start an explorer subagent unless the diff touches more than 15 files.
Report blocking issues, then non-blocking suggestions, then positives.
Your last message must be the complete report, with no follow-up questions.
其中有三处选择是成本决策。检查清单从技能自己的文件夹读取,所以它在每次运行中位置固定,可以被缓存。关于 explorer 的那句话给委派设了一个阈值,小的 diff 就留在同一个上下文里。最后一条指令让最终消息自成一体,这一点很重要,因为文档说,自定义智能体运行时没有内置的框架提示(即告诉子智能体它的最后一条消息就是完整交接)。
哪种技能负载走哪条路径
| 负载 | 路径 | 原因 |
|---|---|---|
| 有人盯着看的交互式技能 | Pro 上的 Kimi Code,或 API 上的 Highspeed | 延迟能被感知;缓存命中价不变 |
| 跨多个仓库的夜间批量技能 | API 上的标准 kimi-k3.1-pro | 输入和输出价格都是 Highspeed 的一半 |
| 已有的 Claude Code 技能与智能体库 | 带 Kimi Code 设置块的 Claude Code | 月之暗面用它报告编程评测 |
| 已有的 Codex 工作流 | Codex 的 provider 配置块 | 月之暗面有文档,使用 Responses 传输格式 |
| 大量扇出的并行子智能体 | Tier1 或更高的 API | 并发达到 15 或更多 |
| 在仓库中共享同一个智能体库的团队 | 任何路径,同时审查 .agents/ 的改动 | 项目智能体文件可以替换默认提示词 |
我们无法验证的部分
月之暗面的编程基准数字来自它自己的运行,使用 Claude Code 工具链。Artificial Analysis 独立测量的是:发布时 Terminal-Bench 4.0 为 67%,每个指数任务的成本为 $1.98,这是本文用到的仅有的外部数字。在我们读到的来源中,没有任何独立测量说明 K3.1 Pro 在 SKILL.md 工作流中、并行子智能体下或不同强度下的表现。
开放权重承诺在 2026 年 11 月 4 日之前发布。10 月 29 日我们检查 Hugging Face 仓库时,返回的是 HTTP 401,所以现在还不能用 K3.1 Pro 自托管技能运行时,我们也没有许可证或硬件需求可以引用。
平台 Claude Code 指南里用于 K3.1 Pro 的模型字符串尚未确认。各套餐以 token 计的配额没有公布。我们读到的页面没有说明缓存 token 是否计入 TPM 限额。成本表中的 token 数是假设值。请把上面的每一项配置都当作我们读过的文档,而不是我们实际搭建过的设置。
上线前检查清单
- 选择与你的密钥相匹配的路径:会员密钥用 Kimi Code 设置,按量付费密钥用平台端点或 Codex 配置块。
- 在让技能库指向它之前,用确切的模型字符串发一次测试调用。
- 有意识地设置
CLAUDE_CODE_SUBAGENT_MODEL,并决定 Haiku 槽位是否真的应该映射到 K3.1 Pro。 - 让自动压缩窗口与你套餐的真实上下文一致:262,144 或 1,048,576 token。
- 把稳定的技能文本和参考文件放在提示词最前面,把变化的输入放在最后。
- 给任何会派发子智能体的技能加一个阈值。
- 为每个技能设置强度,并在两档设置下比较每个被接受结果的成本。
- 对照你的充值档位,检查你计划使用的扇出宽度。
- 最初几周在控制台中跟踪订阅消耗。
- 把共享仓库中
.kimi-code/agents/和.agents/agents/的改动当作代码来审查。
来源
- Moonshot tech blog, Introducing Kimi K3.1 Pro: https://www.kimi.ai/blog/kimi-k3-1-pro
- Kimi K3.1 Pro pricing page: https://www.kimi.ai/resources/kimi-k3-1-pro-pricing
- Kimi K3.1 Pro API quickstart: https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Recharge and rate limiting: https://platform.kimi.ai/docs/pricing/limits
- Kimi Code, Claude Code setup: https://www.kimi.com/code/docs/en/third-party-tools/claude-code
- Kimi API platform, Claude Code guide: https://platform.kimi.ai/docs/guide/claude-code-kimi
- Kimi API platform, Codex guide: https://platform.kimi.ai/docs/guide/codex-kimi
- Kimi Code CLI, Agent Skills: https://www.kimi.com/code/docs/en/kimi-code-cli/customization/skills.html
- Kimi Code CLI, Agents and Sub-Agents: https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- Kimi Code membership: https://www.kimi.com/code/docs/en/kimi-code/membership.html
- Artificial Analysis, Kimi K3.1 Pro launch benchmarks: https://artificialanalysis.ai/articles/kimi-k3-1-pro-launch-benchmarks
- OpenRouter listing: https://openrouter.ai/moonshotai/kimi-k3.1-pro
- Kimi on X: https://x.com/Kimi_Moonshot/status/2113680718249500786 and https://x.com/Kimi_Moonshot/status/2114450610724708492
关于模型本身,包括完整的基准拆解和开放权重状态,请参阅 AgentPedia 上的配套指南:https://agentpedia.codes/blog/kimi-k3-1-pro-guide

