2026 年 10 月智能体技能的最佳模型:按技能类型划分的路由表
2026 年 10 月哪个模型适合跑哪类智能体技能步骤:按技能类型划分的路由表、Artificial Analysis v5 分数、单任务成本和一次运行的预算示例。
Agent Skills
智能体技能(agent skill)是一组会被读很多次、却只执行少数几次的指令。这个特点让技能流水线的选型和聊天窗口里的选型不一样。由技能驱动的编程智能体每跑一次,都会在每个请求里重复发送同一份 SKILL.md 文本、同一批工具描述和同一份仓库上下文,然后只产出少量新输出。账单主要取决于请求的数量、模型选择花掉多少 token,以及重复前缀的缓存有多便宜,而不是哪个模型的标题分数最高。
这篇文章回答一个很窄的问题,面向编写和运行技能、子智能体和 SKILL.md 工作流的人:2026 年 10 月,哪个模型适合跑哪一类技能步骤? 它使用 2026 年 10 月 27 日发布的 Artificial Analysis 智能指数 v5、各厂商在 10 月 28 日和 29 日读取的官方定价页,以及一个用假设 token 数量搭建的小型成本模型,你可以换成自己的数字。完整榜单、Astra 与 Fable 的对比以及最便宜模型的排名,请看 AgentPedia 上的姊妹文章 Best AI model for coding, October 2026(英文)。这里的内容没有在真实流水线上测过。分数来自 Artificial Analysis,价格来自各厂商,路由规则和预算数字是本文自己的算术和建议。
重新打分对技能流水线意味着什么
Artificial Analysis 在 10 月 27 日重建了它的指数。新增两项评测:FrontierCode 2.0 和 Terminal-Bench-Science 0.1。前者是 Cognition 的私有编程基准,包含 132 个来自真实开源仓库的任务,按维护者是否会合并这次改动来评分。另有三项评测升级,三项被移除,指数的 60% 现在建立在私有或保留答案的测试集上。这个日期之前写的任何比较,包括发布文章里的模型对比表,都用的是另一把尺子。Kimi K3.1 Pro 是最清楚的例子:10 月 23 日发布时它得 55 分,在 v5 下得 46 分。
对技能构建者来说,v5 公告里有三个发现比排名本身更重要。
第一,token。Artificial Analysis 报告说,它测量的每个模型在每个指数任务上生成的输出 token 都比 v4.3 多,中位数从 35k 升到 59k。智能体类评测占 55% 的权重,却占约 90% 的输出 token 中位数。技能流水线就是智能体负载,所以本文里的单任务成本数字,是技能运行成本最接近的公开参照。
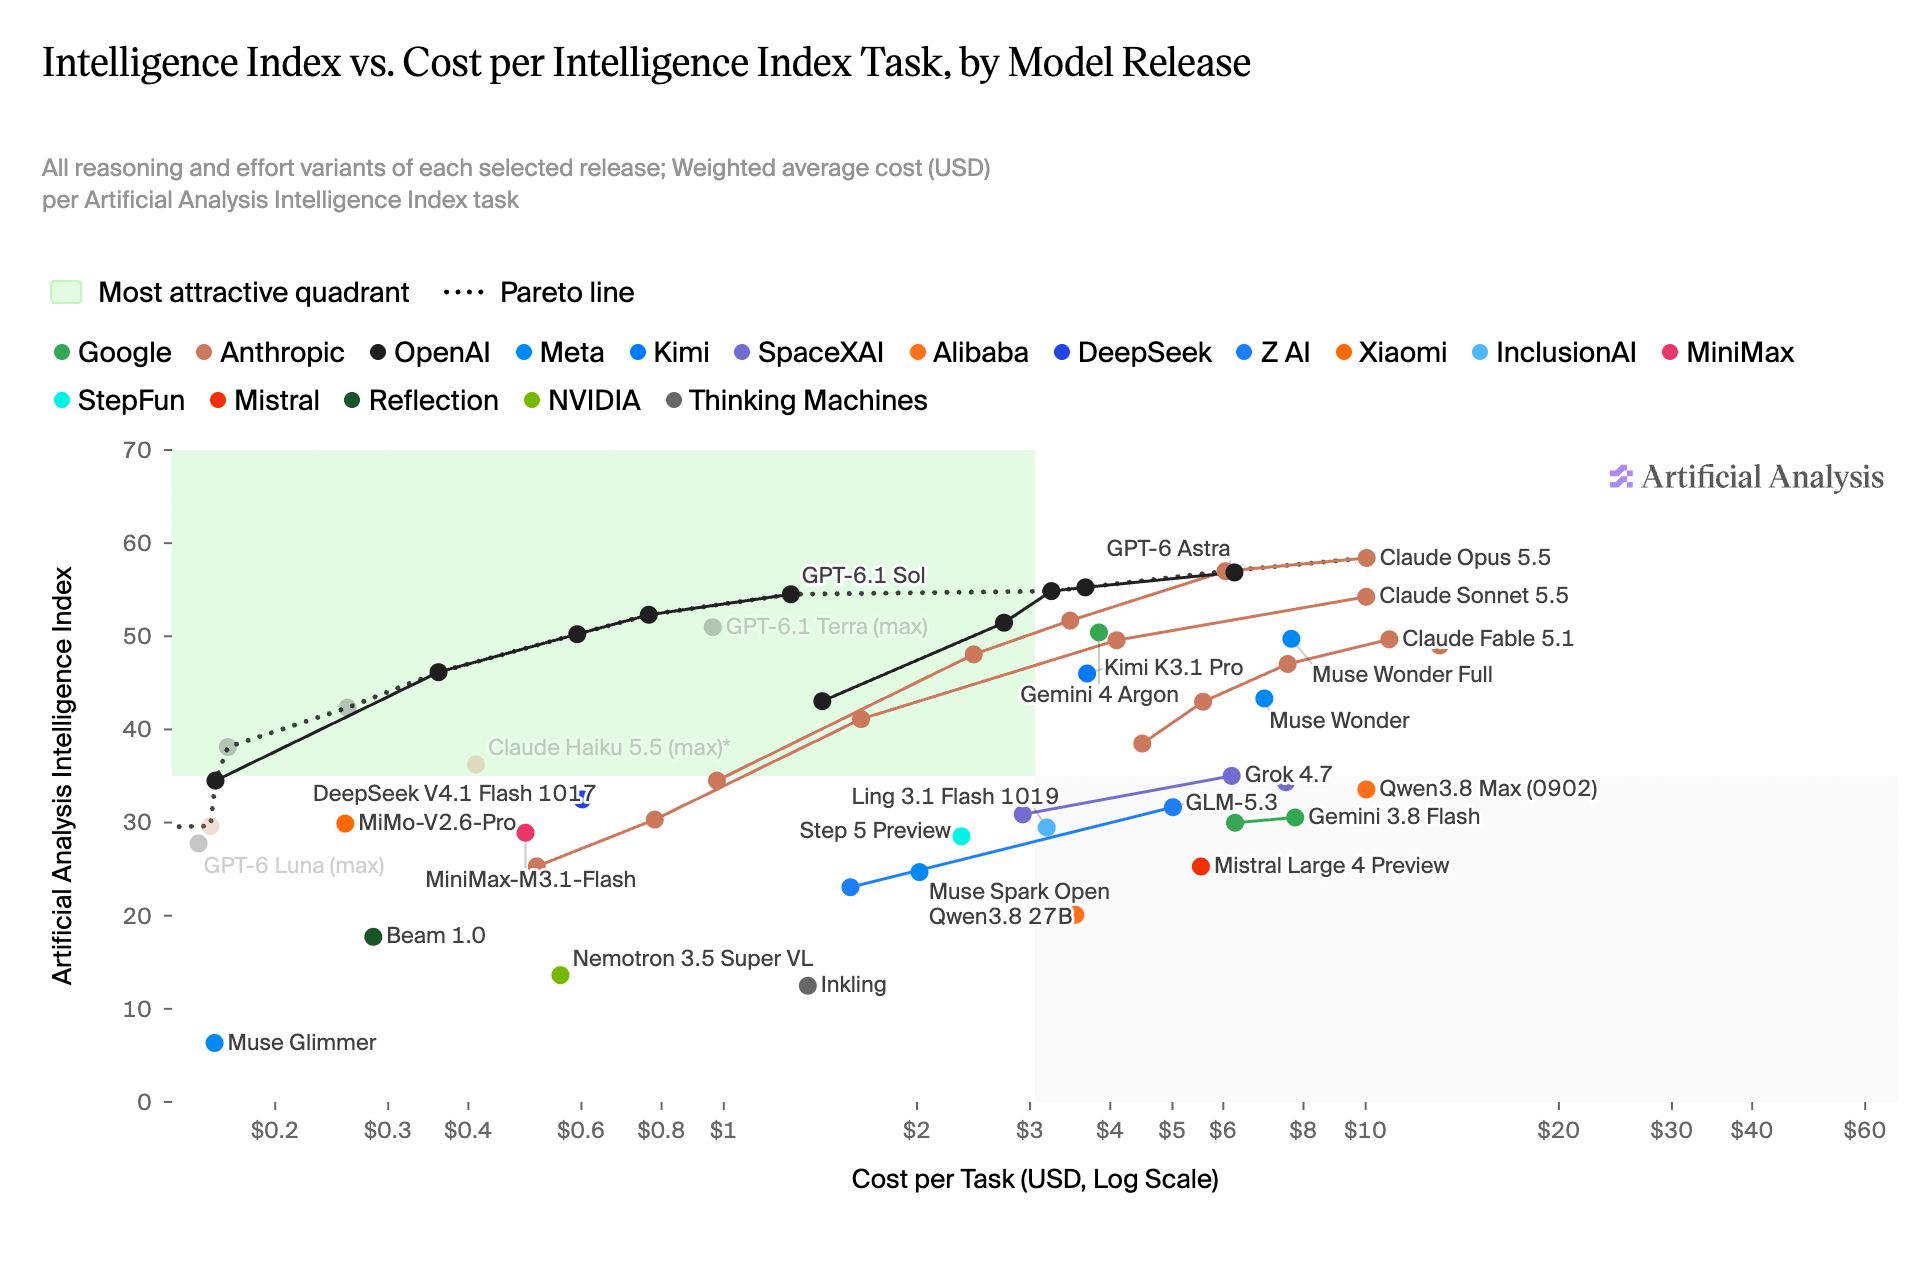
第二,推理力度(effort)。在同一个模型内部,力度设置现在拉开的分差比模型之间的差距还大。Claude Opus 5.5 在低力度下得 35 分,单任务 $0.98;在最高力度下得 58 分,单任务 $10.04。Claude Sonnet 5.5 从低到最高的分差在 v5 下从 20 分扩大到 29 分,GPT-6.1 Sol 的分差翻倍,从 10 分到 20 分。如果你的技能固定了某个力度,这个设置比模型名字更重要。
第三,榜首的顺序和价格表的顺序不一样。Opus 5.5 以 58 分领先,GPT-6 Astra 得 57 分,GPT-6.1 Sol 55 分,Sonnet 5.5 54 分,而 Claude Fable 5.1 得 49 分,标价却和 Astra 一样,都是 $10 和 $50。Gemini 4 Carbon 在 10 月 28 日被报告为 59 分,但目前只向部分用户推出,所以你今天无法把任务路由给它。
按技能类型划分的路由表
下表把常见的技能步骤类型对应到建议先试的模型。“先试”指的是本文证据支持的起点,而不是定论。表中提到的技能都是注册表里的真实条目,档位是建议,应该按本文后面的测试方案在你自己的任务上确认。分数是 Artificial Analysis v5,截至 2026 年 10 月 27 日至 28 日,并标明所用力度。
| 技能类型 | 注册表示例 | 先试 | 升级到 | 原因与带日期的证据 |
|---|---|---|---|---|
| 规划、设计、拆解 | writing-plans、brainstorming | Claude Opus 5.5(中或高) | 最高力度的 Opus 5.5 | v5 以 58 分领先,FrontierCode 2.0 为 46.4%。计划只调用一次,却会放大错误,所以较高的费率只付一次。 |
| 在纪律型技能下实现 | test-driven-development、systematic-debugging | GPT-6.1 Sol(高或超高) | Opus 5.5 | Sol 在高力度下 50 分、单任务 $0.59,超高力度下 52 分、单任务 $0.76。在稳定前缀上发起大量请求,正好是它 5% 缓存价格发挥作用的地方。 |
| 审查与验证 | code-review、verification-before-completion | Claude Opus 5.5(高) | 最高力度的 Opus 5.5 | 审查是对他人 diff 的判断。Opus 在 FrontierCode 2.0 上领先,这个基准最接近“维护者会不会合并”。 |
| 编排 | dispatching-parallel-agents、subagent-driven-development | 协调者用 Sonnet 5.5(高)或 Sol,工人按任务选 | 计划总是失败时,协调者换 Opus 5.5 | 协调者主要是读结果、写简短指令,不需要最高的输出费率。 |
| 查找、摘要、分诊 | 任何技能里的搜索、分类和压缩步骤 | Claude Haiku 5.5 或 GPT-6.1 Terra | Sol | Haiku 得 36 分、单任务 $0.41,Terra 得 51 分、单任务 $0.96。Anthropic 把 Haiku 定位为 Opus 或 Sonnet 之下的子智能体(厂商自报)。 |
| 文档抽取 | pdf、docx | Haiku 5.5 或 GPT-6 Luna | Terra | 机械、正确与否很清楚、量大。Luna 得 28 分、单任务 $0.15,不适合改代码。 |
| 重终端的研究 | 长 shell 工作流 | GPT-6 Astra(成本次要时) | 超高力度的 Sol | Astra 在 Terminal-Bench-Science 上以 63% 领先。最高力度下单任务 $6.24,所以只适合特定步骤。 |
| 编写技能和工具 | skill-creator、mcp-builder | Sol 或 Sonnet 5.5(高) | Opus 5.5 | 有缺陷的技能文件或工具模式会拖累之后每一次运行,所以编写步骤用更强的模型是便宜的保险。 |
| 自托管或隔离环境的步骤 | 任何有数据驻留限制的步骤 | GLM-5.3-Flash | 经过你自己的测试后换托管模型 | 已发布 MIT 许可权重;抓取时没有 v5 分数,质量只有厂商自报。 |
这张表可以概括为一句话:得分最高的模型负责写计划和评判结果,得分相差几分之内的便宜模型负责漫长的中间部分,最小的模型负责出错成本低、容易发现的工作。后面的小节逐行解释。
为什么单任务成本决定实现步骤的档位
实现步骤消耗了一次技能运行的大部分 token,所以模型选择对账单影响最大的就是这里。两个标价相同的模型,账单可能差很多。Sonnet 5.5 和 GPT-6.1 Sol 都是每百万输入 token $2、每百万输出 token $10。在最高力度下,Artificial Analysis 测得 Sonnet 每个指数任务 $10.02,Sol 是 $1.27。价格相同,差别在于各自为达到分数花了多少 token:Sonnet 最高力度得 54,Sol 得 55。
把 Sonnet 往下调,这个差距就消失了。高力度下 Sonnet 得 41 分、单任务 $1.64,超高力度下得 50 分、单任务 $4.09。Sol 在高力度下得 50 分、单任务 $0.59,超高力度下得 52 分、单任务 $0.76。在这些任务上,超高力度的 Sol 与高力度的 Opus 5.5 打平(都是 52),单任务成本约为后者的五分之一($0.76 对 $3.46)。这是对 Artificial Analysis 任务集的陈述。你自己的仓库花 token 的方式可能不同,所以才要测量每个完成任务的成本,而不是相信每 token 的费率。
Anthropic 自己的 Sonnet 5.5 页面里有一条脚注,和这幅图景吻合。它报告 FrontierCode 1.1 在最高力度下为 46.2%,超高力度下为 52.1%,并把最高力度下的回落归因于模型触发 Claude Code 里子智能体密集的审查技能的频率(厂商自报,9 月 28 日)。不管原因是什么,这都是技能改变基准结果的一个有记录的例子,也提醒我们力度和技能会相互影响。要求穷尽式审查的技能在更高力度下花费更多,得分却未必更高。
对大多数技能流水线,实现步骤的合理默认做法是:选便宜的模型,用不超出单任务成本预算的最高力度,把 Opus 5.5 留给重试。另一种做法是全程在最高力度下跑最强的模型,这样指数能多拿几分,账单却大约是八倍,只有在失败代价很高的步骤才划算。
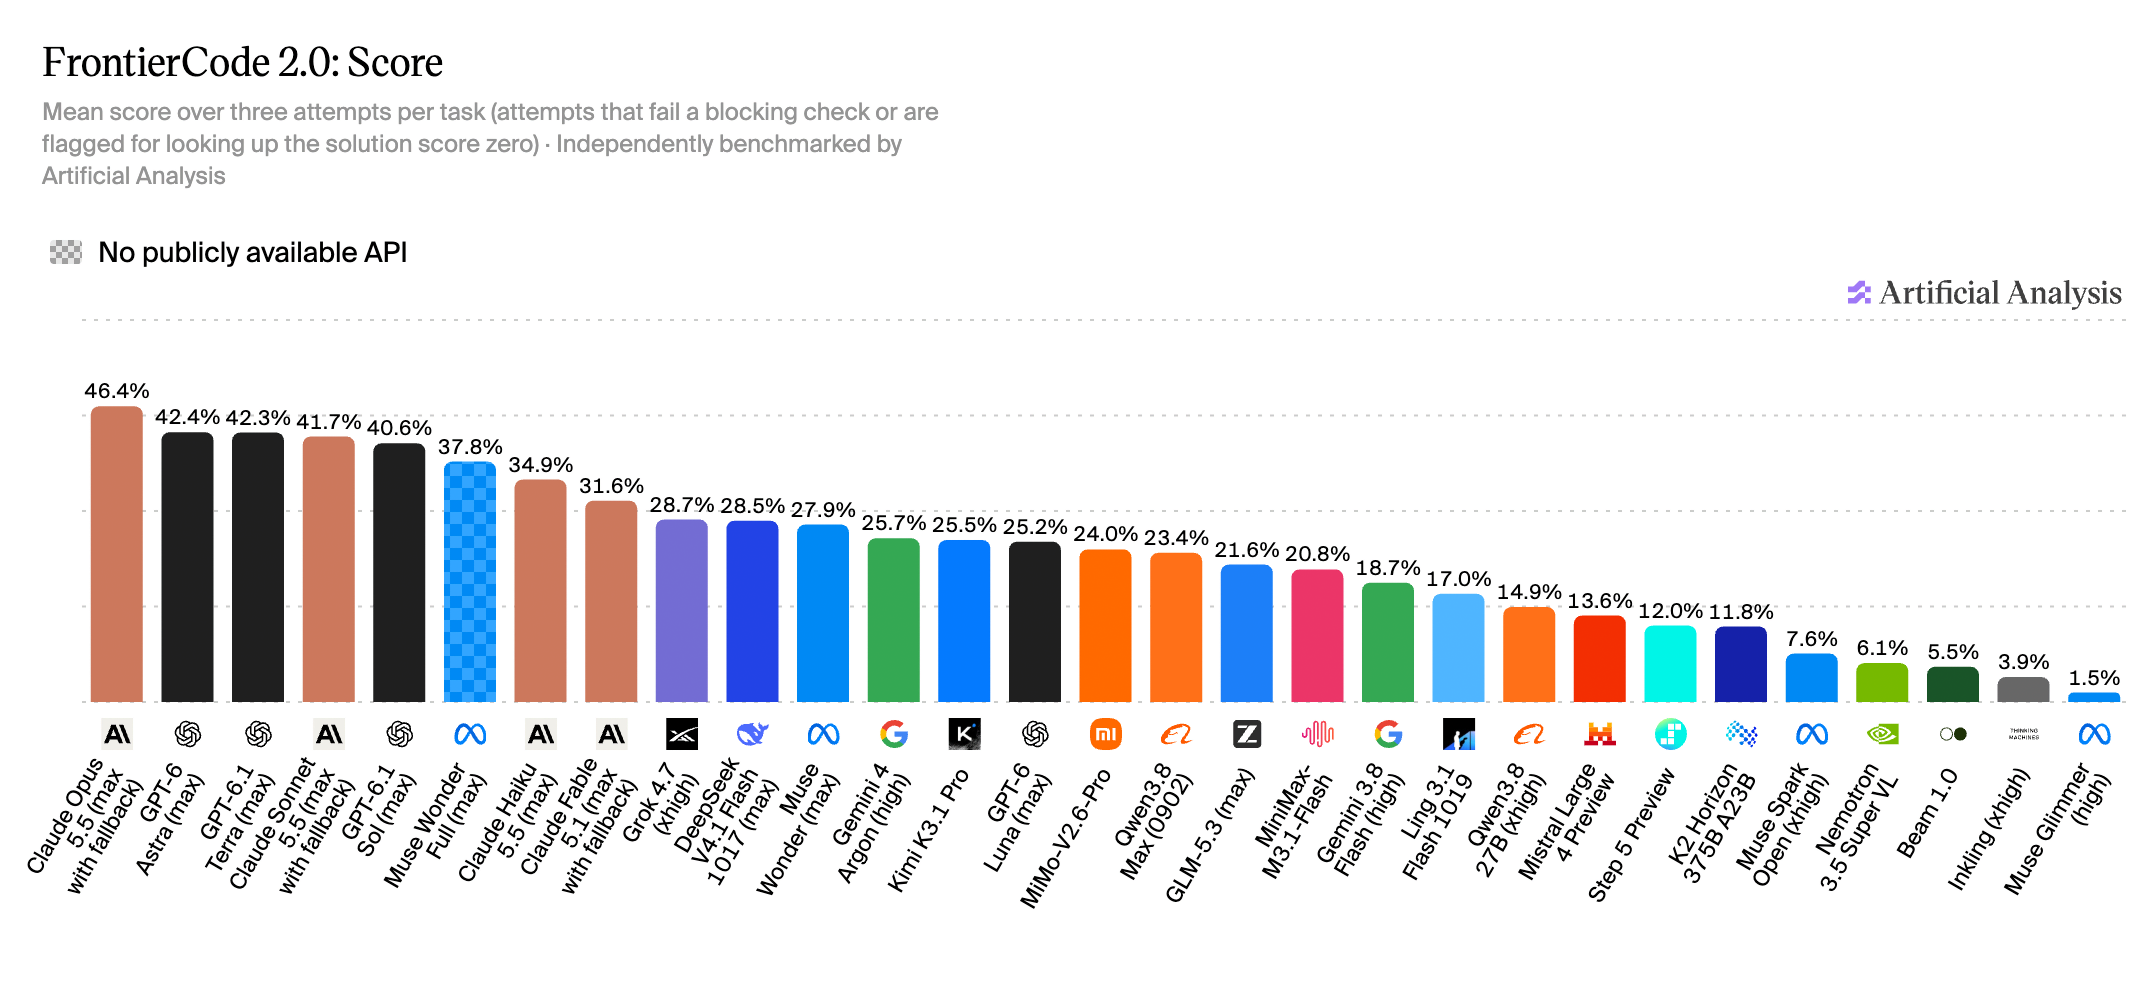
这张图说明为什么表格中间部分是个成本问题。Astra、Terra、Sonnet 和 Sol 都在 40.6% 到 42.4% 之间,这个差距 132 个任务和三次运行分辨不出来。每百万 token $1 和 $5 的 Terra,与 $10 和 $50 的 Astra 只差不到零点一个百分点。质量这么接近时,由各模型的缓存价格和 token 食量决定档位,而这恰好是技能流水线能控制的两件事。
规划与头脑风暴类技能
writing-plans 和 brainstorming 这类规划技能产出的是后续每一步都要遵循的产物。计划里的一个错误,会被每个读到它的工人重复一遍。这种不对称就是在这里使用得分最高的模型的理由:这一步每个任务只跑一次,输出很短,更好的计划只多花几美分。
按列表价和本文后面的预算模型,一次规划调用用 30,000 个未缓存输入 token 和 6,000 个输出 token,在 Opus 5.5 上约 $0.24,在 Astra 上约 $0.60,Astra 贵 2.5 倍,而在独立的编程基准上领先的是 Opus。Astra 的适用面比看起来窄。Astra 在 Terminal-Bench-Science 上以 63% 领先,在 CritPt v2 上为 72%,所以为长篇科学任务或终端研究任务写计划时,可以试一试它。普通的仓库工作,先从 Opus 开始。
力度数据给出一条实用规则:规划用中或高,不要用最高。Opus 5.5 在中力度下得 48 分、单任务 $2.45,高力度 52 分、$3.46,最高力度 58 分、$10.04。从高到最高多花近三倍,只多六分。计划是对结构的判断,而不是对大量尝试的搜索,所以在为最高力度付费之前,先确认更便宜的设置写出的计划你的工人是否能照着做。
在 TDD 与调试技能下实现
test-driven-development 和 systematic-debugging 这类技能会强制形成读取、运行测试、编辑、再运行的循环。这个循环里每个请求都带着同样的长前缀:技能文本、仓库上下文和到目前为止的历史。这就是缓存输入定价最重要的负载,所以值得直接比较缓存价相对于输入价的比例。
| 模型 | 每百万输入 | 每百万缓存输入 | 缓存价占输入价比例 |
|---|---|---|---|
| Claude Opus 5.5 | $4.00 | $0.20 | 5% |
| Claude Sonnet 5.5 | $2.00 | $0.10 | 5% |
| Claude Haiku 5.5(提示不超过 100k) | $0.10 | $0.01 | 10% |
| Claude Fable 5.1 | $10.00 | $0.25 | 2.5% |
| GPT-6 Astra | $10.00 | $1.00 | 10% |
| GPT-6.1 Sol | $2.00 | $0.10 | 5% |
| GPT-6.1 Terra | $1.00 | $0.05 | 5% |
| Kimi K3.1 Pro | $2.00 | $0.20 | 10% |
| GLM-5.3-Flash | $0.15 | $0.03 | 20% |
价格来自各厂商的定价页,读取时间为 2026 年 10 月 28 日至 29 日。从表里能得出两点。Fable 5.1 的缓存折扣最深,所以在重缓存的循环里它与 Astra 的成本差距会缩小,但 Artificial Analysis 测得的单任务成本已经包含了测试时的缓存情况,仍然把 Fable 放在 $13.04,Astra 是 $6.24。另外 Haiku 5.5 有一道档位分界:超过 100,000 个 token 的提示会变成输入 $0.50、缓存 $0.05、输出 $2.50。一份很长的 SKILL.md 加上大仓库,可能让工人悄悄越过这条线,所以 Haiku 步骤要记录提示大小。
对这个循环本身,Sol 是第一个该测试的模型。GPT-6.1 Sol 发布文章说,它在智能体编程上接近 Astra,价格只有五分之一(厂商自报,9 月 29 日),独立数据的形状也一样:55 分对 57 分,单任务成本约为 Astra 的五分之一。Sol 也没有在 v5 的任何一项评测上排第一,这正是要在你的任务上测试它而不是想当然的理由。我们之前的文章 GPT-6.1 Sol for coding agents 介绍了它的基准配置,Routing agent skills across GPT-6 Astra, Sol and Luna 比本文更深入地讲了 OpenAI 的各个档位。
审查与验证类技能
code-review 和 verification-before-completion 这类审查技能检查的是另一个步骤产出的工作。把审查路由给最强模型的理由,不是审查比写代码更难,而是和作者有相同盲点的审查者几乎没有增量价值。如果同一个模型家族写了代码又来审查,审查就和它检查的工作相关联。
一个简单的模式是让审查者使用与实现者不同的档位或家族。如果是 Sol 或 Sonnet 写的改动,就让 Opus 5.5 在高力度下审查。Opus 在 FrontierCode 2.0 上以 46.4% 领先,而这个基准按维护者是否会合并来给改动评分,这正是审查者要回答的问题。对于要审查大量小 diff 的技能,可以先用便宜的审查者做第一遍,再对被标记的改动做 Opus 一遍,这样昂贵的模型只处理少数真正需要它的改动。
力度的教训在这里同样适用:要求模型穷尽并运行子智能体的审查技能,在更高力度下会更贵,而上面 Sonnet 的脚注显示,更多的审查活动并没有提高一个厂商自报的分数。在提高力度之前,先在技能里设限,比如每次审查调用最多处理多少个文件。
编排与子智能体类技能
dispatching-parallel-agents 和 subagent-driven-development 是路由变得字面意义上的地方,因为协调者和它的工人是独立的模型调用,可以跑在不同档位上。如果你的客户端允许为每个子智能体设置模型,有用的划分方式是按各个角色的产出来分。协调者读报告、写简短的分配,适合中等价位、高力度的模型。写代码的工人需要实现档位。负责搜索、摘要或分类的工人只需要最小的档位。
Anthropic 的 Claude Haiku 5.5 发布文章把这个模型定位在这个角色上,说它适合与 Opus 5.5 和 Sonnet 5.5 搭配,作为做摘要、压缩、数据库查询和分类的子智能体,同时说复杂的智能体编程 Sonnet 和 Opus 仍然更好(厂商自报,10 月 7 日)。独立数据与此吻合:Haiku 在指数上得 36 分,FrontierCode 2.0 为 34.9%,Terminal-Bench-Science 为 20%。它在 FrontierCode 2.0 上还超过了 Fable 5.1(31.6%),再次说明价格档位不能预测排名。
并行也会放大 token 开销。十个工人各做一个 $0.59 的任务就是 $5.90,如果每个工人都重新读一份 20,000 token 的技能包,缓存命中率就成了要盯的项目。using-git-worktrees 能防止并行工人互相覆盖文件,但对账单没有帮助。在启用扇出之前,先为它做预算。
查找、抽取与分诊
正确与否定义清楚的步骤,最适合交给最小的模型,因为错误答案容易发现、重试也便宜。用 pdf 或 docx 抽取字段、给 issue 分类、给日志写摘要、压缩历史,都属于这一类。候选是输入 $0.10、输出 $0.50 的 Haiku 5.5,$1 和 $5 的 GPT-6.1 Terra,以及 $0.10 和 $0.50 的 GPT-6 Luna。
从独立数据看,GPT-6.1 Terra 是其中最有意思的一个。它在最高力度下指数得 51 分、单任务 $0.96,FrontierCode 2.0 为 42.3%,Artificial Analysis 称它是得分最高的十个模型里最便宜的,并指出 Terra 与 Fable 5.1 之间的成本差距超过 13 倍。这让它不仅是个分诊工人,也是简单、规格清晰的任务的一个可行实现模型。GPT-6 Luna 得 28 分、单任务 $0.15,适合分类和路由。别让它碰编辑代码的步骤。
这一档的规则是给每个步骤配一个便宜的自动检查。返回文件路径的查找,可以通过打开文件来验证。抽取结果可以按模式校验。摘要可以对照原文抽查。如果你写不出检查,这个步骤大概就不该放在最小的档位上。
编写技能与工具
skill-creator 和 mcp-builder 与其他几行不同,因为它们产出的东西会被之后每次运行读到。含糊的技能描述会让模型加载错误的技能。过宽的工具模式会让它在参数上浪费 token。这两种成本在每个请求里都会重复出现,所以编写步骤值得用比其 token 数量暗示的更强的模型。
常规技能用高力度的 Sol 或 Sonnet 5.5,当技能里编码了微妙的策略(比如安全审查清单,或者不能被改写的迁移规则)时用 Opus 5.5。编写完成之后,用便宜的模型跑一遍新技能,看它在哪里出错。只在最强模型上才能用的技能,带着隐藏的依赖,第一次为了省钱把某一步降档时就会失败。
一次技能运行的预算示例
为了让各档位具体起来,下表给一次假设的四步技能运行定价。规划是一次调用,30,000 个未缓存输入 token 和 6,000 个输出 token。实现是 20 个请求,合计 200,000 个未缓存输入 token、1,000,000 个缓存输入 token 和 30,000 个输出 token。审查是一次调用,40,000 个未缓存输入 token、100,000 个缓存输入 token 和 8,000 个输出 token。查找是十个小调用,合计 150,000 个未缓存输入 token 和 10,000 个输出 token。这些是假设,不是测量。所有美元数字都是按列表价算出来的。
| 方案 | 规划 | 实现 | 审查 | 查找 | 合计 |
|---|---|---|---|---|---|
| 全部用 Claude Opus 5.5 | $0.24 | $1.60 | $0.34 | $0.80 | $2.98 |
| 全部用 Claude Sonnet 5.5 或 GPT-6.1 Sol | $0.12 | $0.80 | $0.17 | $0.40 | $1.49 |
| 全部用 GPT-6 Astra | $0.60 | $4.50 | $0.90 | $2.00 | $8.00 |
| Opus 规划和审查,Sol 实现,Haiku 做查找 | $0.24 | $0.80 | $0.34 | $0.02 | $1.40 |
| 全程 Sol,Haiku 做查找 | $0.12 | $0.80 | $0.17 | $0.02 | $1.11 |
| Opus 规划和审查,Terra 实现,Haiku 做查找 | $0.24 | $0.40 | $0.34 | $0.02 | $1.00 |
在这些假设下,路由后的方案并没有比全程 Sol 便宜多少,而这正是有用的发现。把查找移给 Haiku,在 $1.49 的运行里省下约 30 美分。让 Opus 负责规划和审查,又加回约 29 美分。最大的杠杆是实现步骤,最大的风险是全程 Astra 的 $8.00,是 Sol 基线的五倍多。如果每天跑几百次这样的运行,每次 $1.00 和 $8.00 的差别,就是舍入误差和一项预算开支之间的差别。
有两点提醒让这个结论保持诚实。表格忽略了各模型的 token 食量:在 Artificial Analysis 的任务上,最高力度的 Sonnet 每个任务的花费远高于它的标价所暗示的,所以真实的 Sonnet 行可能明显高于 Sol 行。表格还假设每一步第一次就成功。一个 30% 的情况下要在 Opus 上重试的路由方案,成本会不同,所以在比较方案之前,要先算出升级率。
技能流水线里的开放权重
有些团队因为数据驻留、离线运行或固定的硬件预算,会把某些步骤路由给自己托管的模型。本月的情况是两头分开的。8 月 26 日发布的 GLM-5.3-Flash 在 Hugging Face 上有公开的 MIT 权重,总参数 320B、激活参数 18B,Z.ai 定价页上的 API 价格是每百万 token 输入 $0.15、输出 $0.50。Z.ai 报告 DeepSWE v1.1 为 63.4(厂商自报,对比的是更早一代的 Claude)。我们读到的 Artificial Analysis 榜单上它没有 v5 分数,所以它对你的技能质量如何,需要测试而不是假设。我们的文章 GLM-5.3-Flash for agent skills 讲了运行它需要什么。
Kimi K3.1 Pro 则是相反的情况。Artificial Analysis 在 v5 上给它 46 分、单任务 $3.68,是得分最高的开放权重模型,并把它列为 Terminal-Bench 4.0 的领先者,67%。Moonshot 说权重会在 2026 年 11 月 4 日前发布,而我们在 10 月 29 日检查时,Hugging Face 仓库返回 HTTP 401。在权重发布之前,Kimi 是一个定价 $2 和 $10 的托管 API 模型,而不是开放权重选项。它与技能文件配合的表现见 Kimi K3.1 Pro for agent skills。
v5 数据给自托管者提供了一个现实检验。在已发布权重的模型里,DeepSeek V4.1 Flash 1017 和 GLM-5.3 领先,都是 32 分,低于 Claude Haiku 5.5 的 36 分,Artificial Analysis 说开放权重的差距从 3 分扩大到了 12 分。如果你自托管的原因是质量,v5 的结果不太好看。如果原因是控制数据去向,它什么也没改变,用自托管模型做抽取和分诊步骤仍然是合理的选择。
路由时的失败模式
为某一个模型写的技能文本。 在 Opus 上调好的技能,可能依赖小模型做不出的推断。每个技能都要在你计划使用的最便宜档位上测试,而不只是在你写它的那个档位上。
力度固定在错误的地方。 如果技能把只做分类的步骤写死为高力度,你就在为没人需要的推理付费。如果在规划上固定为低力度,你会在之后的重试里付出代价。把力度放在路由配置里,而不是散落在各个技能文件中。
提示档位的悬崖。 Haiku 5.5 的 100,000 token 分界线是看得见的那一个。在假设所有提示大小都按统一费率之前,先查看你的客户端和厂商文档里有没有类似的阈值。
永不停止的升级。 “在更强的模型上重试”这个规则如果没有上限,就会在困难情形下把便宜的流水线变成 Opus 流水线。限制每个任务的升级次数并记录日志。
混用不同的运行环境。 在 Claude Code 里跑 Opus,在 Codex 里跑 Sol,比较的是产品,也是模型。Artificial Analysis 把它的编程智能体指数与模型分数分开,就是这个原因。测试时,给所有候选使用同一个运行环境。
过期的榜单。 v5 在上一次排名之后的四天内就重排了榜单。在你自己的文档里给每个分数标注日期,并在厂商发布新模型或调整价格时重新运行你的测试集。
在投入之前测试路由方案
一个恰当的检查大约需要一天。目标是在你自己的任务上,测出每个路由方案的每个完成任务的成本,并用一种公平的方式比较各方案。
# Illustrative routing plan, not a client schema. Adapt to your agent host.
steps:
  plan:    { model: claude-opus-5-5,   effort: high,   skills: [writing-plans] }
  build:   { model: gpt-6.1-sol,       effort: xhigh,  skills: [test-driven-development, systematic-debugging] }
  review:  { model: claude-opus-5-5,   effort: high,   skills: [code-review] }
  lookup:  { model: claude-haiku-5-5,  effort: low,    skills: [] }
limits:
  max_escalations_per_task: 1
  max_cost_per_task_usd: 3.00
把同样的 20 到 40 个已关闭的 issue 跑过每个方案,并保留原有的失败测试或验收检查。记录总 token 数、缓存命中率、升级次数,以及每个通过检查的任务的成本。丢掉每个完成任务成本没有比单模型基线低到你在意的幅度的方案。然后每次只改一件事,比如把 build 从 Sol 换成 Terra,这样你就知道是哪个改动让数字变了。
保留这个任务集。下一个模型发布时,重新跑一遍。指数还会再变,只有你自己的任务集,才反映你的仓库。
实际结论
对 2026 年 10 月的技能流水线,独立证据支持一个三档的形状。在一次调用决定其后所有内容质量的地方使用 Claude Opus 5.5,也就是规划、审查和困难的重试。漫长的实现中间段用 GPT-6.1 Sol,更简单的工作用 GPT-6.1 Terra,力度取高或超高,因为它们的单任务成本只是榜首模型的一小部分。查找、抽取和分诊用 Claude Haiku 5.5 或 GPT-6 Luna,并对每个输出配一个便宜的检查。
把 GPT-6 Astra 当作针对重终端研究的有意选择,而不是默认选项;把 Claude Fable 5.1 看作必须在你的任务上证明自己的模型;把 Gemini 4 Carbon 当作正式开放之前值得关注的名字。对自托管,GLM-5.3-Flash 现在有权重但没有独立的 v5 分数,Kimi K3.1 Pro 有分数但权重还没发布。以上都只是起点假设。唯一算数的数字,是你自己仓库上每个完成任务的成本。
FAQ
2026 年 10 月我的智能体技能应该用哪个模型?
没有单一答案。在 Artificial Analysis 智能指数 v5(2026 年 10 月 27 日)上,Claude Opus 5.5 以 58 分领先,是规划和审查的最强选择。GPT-6.1 Sol 得 55 分,单任务 $1.27,而 Opus 是 $10.04,所以它是长实现循环里第一个该测试的模型。Haiku 5.5 或 Terra 负责便宜的查找。
做由技能驱动的编程,GPT-6.1 Sol 比 Claude Sonnet 5.5 更好吗?
两者标价相同,都是每百万 token $2 和 $10。在 Artificial Analysis 的任务上,最高力度下 Sol 得 55 分、单任务 $1.27,Sonnet 得 54 分、单任务 $10.02,所以 Sol 用少得多的 token 达到相近的分数。力度调低后 Sonnet 掉得更快:高力度下 41 分、$1.64,而 Sol 高力度下是 50 分、$0.59。请在你自己的任务上测试两者。
每个技能步骤都应该用最便宜的模型吗?
不应该。只在有自动检查的步骤上使用最小的模型,比如抽取、分类和查找。Haiku 5.5 在指数上得 36 分,Terminal-Bench-Science 为 20%,Anthropic 说复杂的智能体编程 Sonnet 和 Opus 仍然更好(厂商自报)。在规划或审查上使用便宜模型,往往会在之后的重试里花更多钱。
模型路由能省多少钱?
这取决于你的 token 数量。在本文假设的四步运行里按列表价算,全部用 Opus 5.5 是 $2.98,全部用 Sol 是 $1.49,全部用 Astra 是 $8.00,Sol 负责实现、Haiku 做查找的路由方案是 $1.11 到 $1.40。最大的节省来自选择实现模型,而不是把查找路由出去。这些是算术,不是测量。
力度比模型更重要吗?
对某些模型来说是的。Opus 5.5 在低力度下得 35 分,最高力度下得 58 分,单任务分别是 $0.98 和 $10.04。在 v5 下,Sonnet 5.5 从低到最高的分差扩大到了 29 分。在路由配置里按步骤固定力度,并且在比较方案时,把力度的变化当作模型的变化来对待。
现在能为技能步骤自托管一个模型吗?
GLM-5.3-Flash 在 Hugging Face 上有 MIT 权重,Z.ai 的 API 是每百万 token $0.15 和 $0.50,但我们检查时 Artificial Analysis 没有显示它的 v5 分数,所以它的质量只有厂商自报。Kimi K3.1 Pro 有最高的开放权重分数 46,但截至 10 月 29 日它的权重还没发布,Moonshot 承诺在 11 月 4 日前发布。
Gemini 4 Carbon 是我现在能路由到的模型吗?
还不能。Artificial Analysis 在 10 月 28 日报告它在指数 v5 上得 59 分,但说 Google 只向部分用户推出,尚未公开提供。我们没有找到确认的正式开放日期。在它的编程智能体指数上,它得 59 分,而 Claude Code 搭配 Opus 5.5 是 62 分,所以它在编程智能体方面并没有取代 Opus。
Sources
来源均在 2026 年 10 月 28 日至 29 日读取。厂商自报的数字已在正文中标注。
- Announcing Artificial Analysis Intelligence Index v5(2026 年 10 月 27 日),以及 X 上的发布帖
- Artificial Analysis 模型榜单,10 月 28 日抓取
- Artificial Analysis 关于 Gemini 4 Carbon 的帖子(10 月 28 日)
- Introducing Claude Opus 5.5、Claude Sonnet 5.5 和 Claude Haiku 5.5,以及 Anthropic API 定价
- Introducing GPT-6.1 Sol 和 OpenAI API 定价
- Kimi K3.1 Pro 发布博客、Kimi 定价 和 X 上的发布帖
- GLM-5.3-Flash 发布文章、Z.ai 定价 和 Hugging Face 仓库
- X 上的 Claude Haiku 5.5 发布帖


